商品详情
定价:99.0
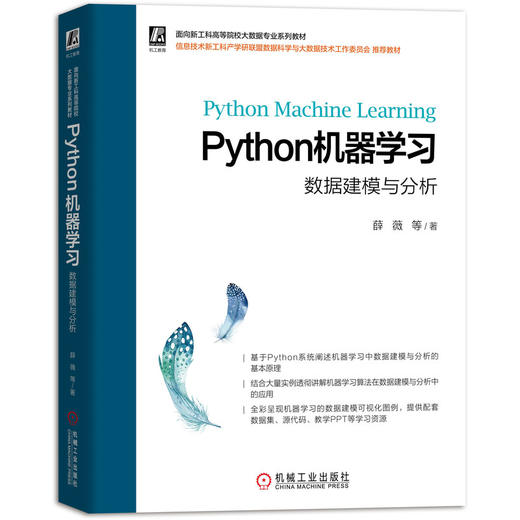
ISBN:9787111674900
作者:薛薇
版次:1
内容提要:
内容简介 |
本书采用理论与实践相结合的方式,引导读者以Python为工具,以机器学习为方法,进行数据的建模与分析。本书共13章,对机器学习的原理部分进行了深入透彻的讲解,对机器学习算法部分均进行了Python实现。除前两章外,各章都给出了可实现的实践案例,并全彩呈现数据可视化图形。 本书兼具知识的深度和广度,在理论上突出可读性,在实践上强调可操作性,实践案例具备较强代表性。随书提供全部案例的数据集、源代码、教学PPT、关键知识点,教学辅导视频,具备较高实用性。 本书既可以作为数据分析从业人员的参考书,也可作为高等院校数据分析、机器学习等专业课程的教材。 扫描关注机械工业出版社计算机分社官方*订阅号—身边的信息学,回复67490即可获取本书配套资源下载链接。 |
目录:
目录 |
目录 前言 *1章 机器学习概述1 1.1 机器学习的发展:人工智能中的 机器学习1 1.1.1 符号主义人工智能1 1.1.2 基于机器学习的人工智能2 1.2 机器学习的核心:数据和数据建模4 1.2.1 机器学习的学习对象:数据集4 1.2.2 机器学习的任务:数据建模6 1.3 机器学习的典型应用11 1.3.1 机器学习的典型行业应用11 1.3.2 机器学习在客户细分中的应用12 1.3.3 机器学习在客户流失分析中的 应用13 1.3.4 机器学习在营销响应分析中的 应用14 1.3.5 机器学习在交叉销售中的应用15 1.3.6 机器学习在欺诈甄别中的应用16 【本章总结】16 【本章习题】17 *2章 Python机器学习基础18 2.1 Python:机器学习的*选工具18 2.2 Python的集成开发环境: Anaconda19 2.2.1 Anaconda的简介19 2.2.2 Anaconda Prompt的使用20 2.2.3 Spyder的使用22 2.2.4 Jupyter Notebook的使用23 2.3 Python第三方包的引用24 2.4 NumPy使用示例24 2.4.1 NumPy数组的创建和访问25 2.4.2 NumPy的计算功能26 2.5 Pandas使用示例29 2.5.1 Pandas的序列和索引29 2.5.2 Pandas的数据框30 2.5.3 Pandas的数据加工处理31 2.6 NumPy和Pandas的综合应用:空气质量监测数据的预处理和基本分析32 2.6.1 空气质量监测数据的预处理32 2.6.2 空气质量监测数据的基本分析34 2.7 Matplotlib的综合应用:空气质量监测数据的图形化展示36 2.7.1 AQI的时序变化特点37 2.7.2 AQI的分布特征及相关性分析38 2.7.3 优化空气质量状况的统计图形40 【本章总结】41 【本章相关函数】41 【本章习题】47 第3章 数据预测与预测建模49 3.1 数据预测的基本概念49 3.2 预测建模50 3.2.1 什么是预测模型50 3.2.2 预测模型的几何理解53 3.2.3 预测模型参数估计的基本策略56 3.3 预测模型的评价59 3.3.1 模型误差的评价指标60 3.3.2 模型的图形化评价工具62 3.3.3 泛化误差的估计方法64 3.3.4 数据集的划分策略67 3.4 预测模型的选择问题69 3.4.1 模型选择的基本原则69 3.4.2 模型过拟合69 3.4.3 预测模型的偏差和方差71 3.5 Python建模实现73 3.5.1 ROC和P-R曲线图的实现74 3.5.2 模型复杂度与误差的模拟研究75 3.5.3 数据集划分和测试误差估计的实现79 3.5.4 模型过拟合以及偏差与方差的 模拟研究82 3.6 Python实践案例86 3.6.1 实践案例1:PM2.5浓度的 回归预测86 3.6.2 实践案例2:空气污染的分类预测87 【本章总结】91 【本章相关函数】91 【本章习题】91 第4章 数据预测建模:贝叶斯分类器93 4.1 贝叶斯概率和贝叶斯法则93 4.1.1 贝叶斯概率93 4.1.2 贝叶斯法则94 4.2 贝叶斯和朴素贝叶斯分类器94 4.2.1 贝叶斯和朴素贝叶斯分类器的 一般内容94 4.2.2 贝叶斯分类器的先验分布96 4.3 贝叶斯分类器的分类边界99 4.4 Python建模实现100 4.4.1 不同参数下的贝塔分布101 4.4.2 贝叶斯分类器和Logistic回归 分类边界的对比101 4.5 Python实践案例103 4.5.1 实践案例1:空气污染的分类 预测103 4.5.2 实践案例2:法律裁判文书中的 案情要素分类105 【本章总结】110 【本章相关函数】111 【本章习题】111 第5章 数据预测建模:近邻分析112 5.1 近邻分析:K-近邻法112 5.1.1 距离:K-近邻法的近邻度量113 5.1.2 参数K:1-近邻法还是K-近邻法114 5.1.3 与朴素贝叶斯分类器和Logistic 回归模型的对比117 5.2 基于观测相似性的加权K-近邻法117 5.2.1 加权K-近邻法的权重117 5.2.2 加权K-近邻法的预测119 5.2.3 加权K-近邻法的分类边界119 5.3 K-近邻法的适用性120 5.4 Python建模实现122 5.4.1 不同参数K下的分类边界122 5.4.2 不同核函数的特点123 5.4.3 不同加权方式和K下的分类边界124 5.5 Python实践案例125 5.5.1 实践案例1:空气质量等级的 预测125 5.5.2 实践案例2:国产电视剧的大众 评分预测127 【本章总结】129 【本章相关函数】129 【本章习题】130 第6章 数据预测建模:决策树131 6.1 决策树概述131 6.1.1 什么是决策树131 6.1.2 分类树的分类边界133 6.1.3 回归树的回归平面134 6.1.4 决策树的生长和剪枝135 6.2 CART的生长139 6.2.1 CART中分类树的异质性度量139 6.2.2 CART中回归树的异质性度量140 6.3 CART的后剪枝141 6.3.1 代价复杂度和*小代价复杂度141 6.3.2 CART的后剪枝过程142 6.4 Python建模实现143 6.4.1 回归树的非线性回归特点144 6.4.2 树深度对分类边界的影响145 6.4.3 基尼系数和熵的计算146 6.5 Python实践案例147 6.5.1 实践案例1:空气污染的预测 建模147 6.5.2 实践案例2:医疗大数据应用— 药物适用性研究151 【本章总结】154 【本章相关函数】155 【本章习题】155 第7章 数据预测建模:集成学习156 7.1 集成学习概述157 7.1.1 高方差问题的解决途径157 7.1.2 从弱模型到强模型的构建157 7.2 基于重抽样自举法的集成学习158 7.2.1 重抽样自举法158 7.2.2 袋装法158 7.2.3 随机森林161 7.3 从弱模型到强模型的构建163 7.3.1 提升法164 7.3.2 AdaBoost.M1算法165 7.3.3 SAMME算法和SAMME.R 算法170 7.3.4 回归预测中的提升法172 7.4 梯度提升树174 7.4.1 梯度提升算法174 7.4.2 梯度提升回归树178 7.4.3 梯度提升分类树179 7.5 XGBoost算法181 7.5.1 XGBoost的目标函数181 7.5.2 目标函数的近似表达182 7.5.3 决策树的求解183 7.6 Python建模实现185 7.6.1 单棵决策树、弱模型和提升法的 预测对比186 7.6.2 提升法中高权重样本观测的特点187 7.6.3 AdaBoost回归预测中损失函数的 选择问题189 7.6.4 梯度提升算法和AdaBoost的 预测对比189 7.7 Python实践案例191 7.7.1 实践案例1:PM2.5浓度的 回归预测191 7.7.2 实践案例2:空气质量等级的 分类预测195 【本章总结】197 【本章相关函数】197 |
- 机械工业出版社旗舰店 (微信公众号认证)
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...