商品详情
前 言近年来,随着算力的跃升与数据规模的指数级增长,深度学习迎来了历史性的飞跃。神经网络模型的规模从数百万参数迅速扩展至千亿乃至万亿级别,能力边界不断被突破。从颠覆自然语言处理的GPT、DeepSeek,到重塑多模态理解的 CLIP,大模型以惊人的泛化能力和跨领域适应性,重新定义着人工智能的可能性。它不仅突破了传统深度学习的性能瓶颈,更催生出小说创作、代码生成、科学推理等前所未有的应用场景。科学技术从来不是脱离现实的乌托邦,终究要赋能生活、服务大众,从高端前沿走向全民普及。随着技术应用快速落地,大模型正走进每一位普通人的生活,也走进每一个普通开发者、研究人员乃至学生的学习视野。但与此同时,庞大的模型规模、复杂的训练流程、多样的微调方法和飞速演化的算法体系,也让初学者在入门时感到无从下手。本书是笔者继《简明神经网络》与《理解深度学习》之后的第三部系列力作,是一本系统性的大模型入门书籍。我们希望在快速演进的技术浪潮中,为读者提供一条系统、清晰且可落地的大模型学习路径。本书旨在系统剖析大模型的底层机理与实践方法,读者需要掌握神经网络基础概念,并对 Transformer架构、自监督学习等关键技术有初步认知。若读者在阅读本书时对基础概念感到生疏,建议先查阅本系列的前两部作品。需要特别说明的是,鉴于《理解深度学习》一书中已对扩散模型(diffusion model)进行了系统讲解,为避免内容冗余并聚焦核心主题,本书将不再包含扩散模型的相关内容,而是集中篇幅探讨大语言模型的核心组件、训练范式、优化策略及前沿应用等内容,为研究者构建完整的知识框架,为开发者提供落地的技术指南。无论你是具备一定深度学习基础、希望理解大模型原理的读者,还是已有项目实践经验、期望在工作中部署和优化大模型的开发者,都可以在本书中找到适合自身需求的内容。同时,本书知识体系由浅入深、架构严谨,亦适合作为高等院校人工智能、计算机科学及相关专业的本科生与研究生教材。本书共分为七章,逻辑层层递进。第 1 章与第 2 章从大模型的定义与发展历程切入,探讨其与传统深度学习的本质差异,并梳理了从 BERT 到 GPT 的里程碑式演进。重点解构 Transformer 架构, 深入剖析自注意力机制、位置编码等核心组件,并对比分析编码器、解码器及混合架构的特性与适用场景,同时介绍了支撑大模型训练的分布式并行计算技术。第 3 章系统讲解了自监督预训练任务(如自回归、自编码)、预训练策略优化(如 RLHF)以及模型压缩技术(如剪枝、量化、蒸馏),揭示大模型如何习得通用知识。第 4 章则聚焦于如何将通用模型转化为;领域专家,重点解析全量微调与参数高效微调体系,详细阐述了前缀微调、提示词微调、适配器微调以及当下主流的 LoRA 及其变体(如 QLoRA、AdaLoRA),帮助读者在有限算力下实现模型的任务适配。第 5 章针对大模型的;幻觉与知识时效性问题,深入解构检索增强生成(RAG)协同框架。从检索器与生成器的协作原理,到数据的分块与索引机制,再到查询转换、重排序及混合检索等系统优化技术,为构建知识密集型应用提供了通用解决方案。第 6 章探讨了大模型训练的;数据生命线,从预训练数据的收集与清洗,到评估基准的科学设计,最后探讨数据隐私与安全的前沿挑战。通过理论与案例结合,揭示数据驱动 AI 时代的关键规则。第 7 章聚焦落地开发,介绍了 Llama、Qwen、DeepSeek 等主流开源大模型系列及 Hugging Face生态。通过;情感分析微调;本地部署 Qwen2 对话机器人;LoRA 风格化微调以及;构建私有知识库 RAG 系统等实战项目,手把手带领读者完成从模型选择到应用构建的全过程。本书力求理论与实践结合,每章配有练习,并在章节间穿插了;思考与;稍事休息模块。本书使用 Python 作为主要编程语言,并使用 PyTorch 框架作为关键技术的实现示例,帮助读者深入理解技术细节。需要说明的是,大模型训练通常需要 GPU 集群支持,但本书提供的代码经过优化,部分案例可在消费级显卡(如 RTX 4090)上运行。在写作过程中,我们始终秉持;去繁就简、深入浅出的原则,尽力做到少用晦涩的数学公式,多用示例来完成知识的展示。在使用数学理论说明的部分,会对理论推导过程进行详细的说明,方便读者理解。在成书过程中,我们深刻体会到大模型领域日新月异的发展速度,某些技术细节难免会随着研究进展发生变化,尽管我们力求准确严谨,但限于作者水平与技术发展速度,书中难免存在疏漏与不当之处,诚邀读者批评指正,意见请发往邮箱 info_rinc@163.com。本书的编写工作得到了南京大学人工智能学院 RINC 实验室各位同学的大力支持。特别感谢窦慧、郭苏涵、易梦军三位博士,在书稿的修改和校对方面付出的心血;感谢穆欣雨、王瑾、徐志铭、张少丹、杨朗兴、汪宇驰、宗杰、唐乾蔚、邓嘉宏和叶子琪同学,在资料整理、数据收集和实验验证方面付出的辛勤劳动。正是大家的共同努力才促成了本书的顺利出版。最后,愿本书成为你进入大模型世界的一把钥匙,帮助你在技术的森林中拨云见日、稳步前行。祝大家阅读愉快!作 者2026 年 4 月
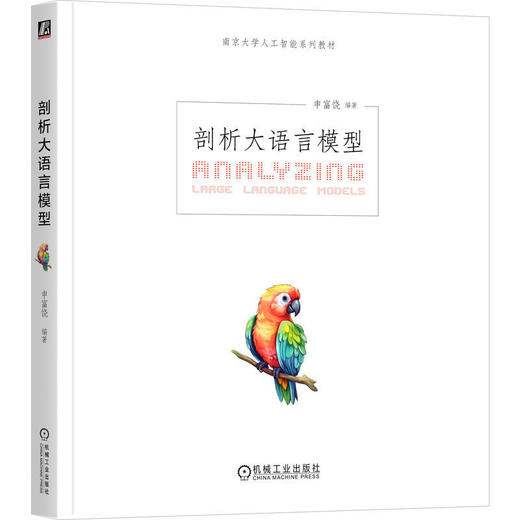
本书力求理论与实践结合,每章都配有练习,并在章节间穿插了;稍事休息环节,介绍相关的技术趣闻与背景故事。全书使用 Python 作为主要编程语言,并使用 PyTorch框架作为关键技术的实现示例,帮助读者深入理解技术细节。本书可作为高等院校人工智能、计算机科学及相关专业的本科生与研究生的教材,也可作为大模型领域技术人员的参考书。
本书是大语言模型的入门书籍,共分为7章,内容由浅入深、逻辑清晰。开篇从大语言模型的基本定义、发展脉络与技术演进讲起,细致拆解Transformer核心架构;随后依次讲解自监督预训练原理、模型高效微调技术、检索增强生成(RAG)框架,以及高质量数据体系构建方法;最后梳理当前主流开源大模型,详解多个实战项目,为读者搭建起清晰的大语言模型学习路径。
申富饶,教授,博士生导师,担任计算机软件新技术国家重点实验室、南京大学人工智能学院、南京大学计算机科学与技术系教授。担任南京大学教学委员会委员,南京大学人工智能学院院长助理,负责南京大学人工智能学院的教学和人才培养工作。在南京大学数学系取得学士、硕士学位,在日本东京工业大学智能系统科学专业取得博士学位。兼任南京大学量子物理与人工智能特聘教授、南京大学科沃斯讲席教授,入选;创业南京科技顶尖专家集聚计划A类专家,担任南京智能制造软件新技术研究院首席科学家,是中国计算机学会系统软件专委会委员、高级会员,江苏省计算机学会理事、组织工委主任,历任日本科学振兴机构研究员、日本学术振兴会外国人特别研究员等。主要研究方向包括神经网络、计算机视觉、机器人智能,主持或参加过国家自然科学基金、973、优秀国家重点实验室专项研究基金等国家级项目以及*、科技部、江苏省自然科学基金等省部级项目,在国内外包括IJCAI、AAAI、CVPR、ATC、FSE等顶级国际会议和IEEE TIP、IEEE TNNLS、Neural Networks等领域内顶级SCI期刊上发表学术论文120余篇,其中被SCI、EI、ISTP收录的论文100余篇,多次担任国际会议分会主席、程序委员会委员,是多个知名国际期刊的审稿人,拥有20余项国家发明专利和4项国际发明专利,出版专著及译著6部。
目 录
前言主要符号表
第 1 章 绪论 11.1 大模型的定义 11.1.1 大模型的核心特征 21.1.2 大模型与深度学习的关系 31.2 大模型的发展历程以及里程碑 51.2.1 大模型的发展历程 51.2.2 大模型的里程碑 81.2.3 重要组织及团队 111.3 大模型的应用场景 131.4 大模型的研究问题 151.5 大模型的未来挑战 181.6 小结 22练习 22
第 2 章 大模型技术的基石 242.1 Transformer 架构 252.1.1 位置编码 252.1.2 注意力机制 282.1.3 前馈网络 342.1.4 残差连接与归一化 352.2 基于 Transformer 的经典大模型及其架构 352.2.1 编码器架构 362.2.2 解码器架构 402.2.3 编码器ndash;解码器架构 422.3 不同架构的优缺点以及适用场景分析 442.4 分布式训练与并行计算技术 47 2.4.1 大模型训练的挑战 472.4.2 数据并行训练 482.4.3 流水线并行训练 522.4.4 张量并行训练 542.5 小结 56练习 56
第 3 章 大模型核心技术 583.1 从自监督到大模型预训练 583.2 预训练任务 603.2.1 自回归 603.2.2 自编码与去噪 623.2.3 对比学习 643.3 对齐策略优化与模型训练 663.3.1 人类反馈强化学习 663.3.2 混合训练策略 713.4 模型压缩与效率提升 733.4.1 剪枝 733.4.2 模型量化 753.4.3 知识蒸馏 763.5 提示词工程 783.5.1 基础提示优化 783.5.2 人工提示优化 783.5.3 自动提示优化 813.5.4 思维链 833.6 小结 85练习 85
第 4 章 大模型微调技术 884.1 微调技术概述 884.1.1 为什么要微调 884.1.2 微调技术分类 884.1.3 高效参数微调的通用架构 914.2 前缀微调 92 4.2.1 原理与方法 934.2.2 实现细节 934.2.3 前缀向量的优化方法 954.3 提示词微调 964.3.1 硬提示 974.3.2 软提示 984.3.3 典型变体 994.3.4 实现技术细节 1024.4 适配器微调 1034.4.1 原理与方法 1034.4.2 经典变体 1054.5 LoRA 微调 1094.5.1 原理与方法 1094.5.2 经典变体 1104.5.3 实现技术细节 1154.6 微调技术比较 1174.7 小结 118练习 119
第 5 章 大模型检索增强生成 1215.1 为什么需要 RAG 1215.2 RAG 架构与工作原理 1235.2.1 检索器 1245.2.2 生成器 1255.2.3 RAG 的架构类型 1265.3 RAG 中的数据准备与索引机制 1275.3.1 数据准备:统一文档对象的构建 1275.3.2 文本分块:让长文变得;可消化 1285.3.3 向量存储与高效索引:让大模型有;记忆力 1305.4 检索器系统优化技术 1325.4.1 查询转换 1325.4.2 重排序 1345.4.3 递归检索 135 5.4.4 混合检索 1365.4.5 检索器微调 1375.5 生成器系统增强机制 1385.5.1 提示工程 1395.5.2 解码调优 1395.5.3 生成器微调 1425.6 小结 143练习 144
第 6 章 大模型的训练数据和评估 1466.1 大模型与数据质量 1466.1.1 为什么需要高质量数据 1466.1.2 数据质量对大模型的影响 1476.2 训练数据收集与预处理 1496.2.1 数据收集 1496.2.2 数据预处理 1516.2.3 数据标注 1656.3 基准测试数据集介绍 1696.3.1 通用能力评估基准 1706.3.2 领域专项评估基准 1716.3.3 伦理安全评估基准 1726.3.4 新兴任务评估基准 1736.4 大模型带来的数据隐私与安全问题 1736.4.1 大模型数据隐私问题 1746.4.2 大模型安全问题 1766.5 小结 178练习 178
第 7 章 大模型部署 1817.1 使用开源大模型进行开发 1817.2 主流开源大模型介绍 1837.2.1 Meta Llama 系列 1837.2.2 OpenAI Community GPT_2 1877.2.3 Google Gemma 系列 188 7.2.4 Alibaba Qwen 系列 1907.2.5 DeepSeek 系列 1937.2.6 总结 1957.3 Hugging Face 介绍 1977.3.1 什么是 Hugging Face 1977.3.2 Hugging Face 的核心功能 1987.3.3 Hugging Face 的使用方法 1987.3.4 实例:使用 Transformers 进行情感分析 2007.3.5 运行环境与输出示例 2037.4 基于开源大模型的构建 2047.4.1 选择合适的开源模型 2047.4.2 在本地部署 Qwen2_0.5B_Instruct 模型 2057.4.3 构建 Web 界面 2087.4.4 运行和测试 2107.5 参数高效微调实战 2117.5.1 LoRA 概述 2117.5.2 实验背景与目标 2127.5.3 实验准备 2127.5.4 实验实现 2137.5.5 实验结果与分析 2177.6 检索增强生成实战 2187.6.1 检索增强生成概述 2187.6.2 实验背景与目标 2187.6.3 实验准备 2197.6.4 实验实现 2207.6.5 测试结果 2247.7 小结 226练习 227
参考文献 230
- 新华一城书集 (微信公众号认证)
- 上海新华书店官方微信书店
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...