商品详情
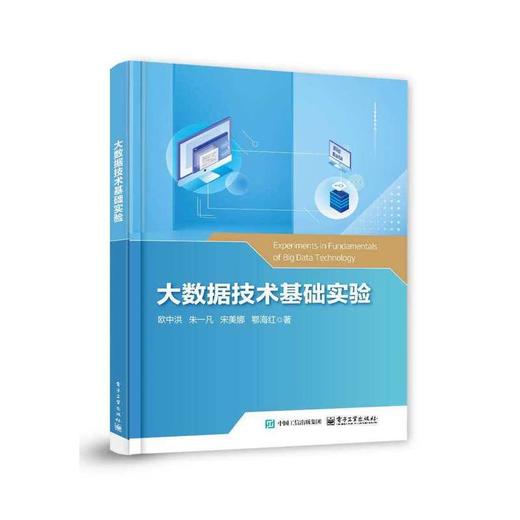
《大数据技术基础实验》是一本面向大数据处理的实验教材,旨在帮助学生从理论学习过渡到实际操作,全面掌握大数据技术的实践应用。本书系统讲解了Spark、Storm、Flink等主流大数据处理框架的实践操作,涵盖了从大数据的存储(HDFS,HBase)到批处理、流处理全过程。教材内容分为六章,每章围绕一个核心主题展开。第一章介绍大数据技术的总体框架、大数据的处理流程和三大核心:HDFS、HBase和MapReduce,让读者从宏观上认识大数据技术。后四章围绕具体实操展开,辅以具体命令和代码,系统介绍从存储――处理――分析的大数据技术全过程。简单说明如下:第二章聚焦于大数据技术的基础――数据存储,具体包括HDFS,HBase等组件的使用。第三章讨论批处理框架,介绍MapReduce、Spark引擎。第四章讨论流处理框架,介绍使用flume和kafka进行数据收集和分发,使用storm等进行流处理。第五章介绍分布式查询引擎Hive、Druid等的使用。第六章为大数据综合实验,通过实际案例让学生综合运用所学知识,完成数据全流程操作。欧中洪,北京邮电大学计算机学院(国家示范性软件学院)长聘教授、博士生导师,人事处副处长、人才办主任,国家重点研发计划青年科学家,北京市青年教学名师。曾任计算机学院(国家示范性软件学院)副院长,现任*虚拟仿真实验教学创新联盟计算机类专委会主任、中国通信标准化协会TC11 VR/AR子工作组副组长、全国高等院校计算机基础教育研究会教育创新与产教融合专委会副主任,CCF教育专委会常务委员,中国人工智能学会智能服务专委会常务委员,CCF大数据/计算机视觉执行委员,中国互联网协会青年专家,CCF高级会员。主持科技创新2030_"新一代人工智能”重大项目等国家和省部级项目20余项,在IEEE TMC、TMM、TNNLS、TCC、ACM SenSys等发表高水平论文80余篇,研究成果曾被BBC News、ACM TechNews、The Register等20余家国际知名媒体报道,获得中国安全生产协会科技进步一等奖、中国产学研合作创新与促进奖等科技奖励多项。研究兴趣包括小样本学习、跨域自适应、小目标检测等。目 ?录第1章 ?大数据概述0011.1 ?大数据简介:什么是“4V”0021.2 ?大数据处理流程:数据的奇妙冒险0051.3 ?大数据具体落地:怎么才算是美味0071.3.1 ?杭州城市大脑0071.3.2 ?京东销量预测0071.4 ?大数据核心组件:将会用到什么0081.4.1 ?大数据采集0081.4.2 ?大数据存储0091.4.3 ?大数据处理0091.4.4 ?大数据分析0111.5 ?总结012第2章 ?大数据存储0132.1 ?什么是Hadoop0142.1.1 ?Hadoop的诞生0142.1.2 ?什么是HDFS0162.2 ?HDFS:仓库管理员0162.2.1 ?部署HDFS集群0172.2.2 ?操作 HDFS 集群0222.2.3 ?HDFS存储文件机制0252.2.4 ?总结0312.3 ?ZooKeeper:分布式系统的协调者0312.3.1 ?ZooKeeper与HDFS0322.3.2 ?HA的背后原理0412.3.3 ?总结0442.4 ?HBase:一个NoSQL数据库0442.4.1 ?HBase介绍0452.4.2 ?部署HBase集群0482.4.3 ?HBase基础操作0542.4.4 ?Java API连接HBase0572.4.5 ?HBase背后的存储原理0592.5 ?总结063第3章 ?大数据处理:批处理0653.1 ?MapReduce介绍0663.1.1 ?MapReduce的历史地位0673.1.2 ?MapReduce的发展历程0683.1.3 ?MapReduce的编程思想0683.1.4 ?总结0733.2 ?Yarn:资源协调者0743.2.1 ?为什么需要Yarn0743.2.2 ?Yarn的思想0763.2.3 ?配置HA_Yarn0783.2.4 ?总结0843.3 ?MapReduce案例0853.3.1 ?准备数据集0853.3.2 ?创建项目,导入相关依赖0863.3.3 ?编写代码0863.3.4 ?运行作业0933.3.5 ?查看作业结果0933.3.6 ?总结0953.4 ?Spark介绍0963.4.1 ?提出 Spark 的原因0973.4.2 ?弹性分布式数据集(RDD)0983.4.3 ?Spark程序运行架构1013.4.4 ?总结1043.5 ?Spark案例1043.5.1 ?编写代码1043.5.2 ?提交Spark程序1063.6 ?总结108?第4章 ?大数据处理:流处理1094.1 ?流处理/批处理区别:着急或不着急1104.1.1 ?流处理(Stream Processing)1114.1.2 ?批处理(Batch Processing)1124.1.3 ?流处理和批处理的区别1124.2 ?初步了解实时数据处理1134.2.1 ?Flume1144.2.2 ?Kafka1154.2.3 ?Storm1164.3 ?数据收集与分发:井然有序的数据传输线1184.3.1 ?Flume1194.3.2 ?Kafka1214.3.3 ?Flume与Kafka整合1244.4 ?数据流处理1264.4.1 ?Storm及其安装配置1264.4.2 ?Flume十Kafka十Storm十HBase整合1294.5 ?其他常见流处理框架1354.5.1 ?Spark Streaming(Spark流处理)1354.5.2 ?Flink1384.5 ?总结140第5章 ?大数据查询与分析1435.1 ?Hive介绍1455.1.1 ?Hive的历史1465.1.2 ?总结1485.2 ?Hive实践1485.2.1 ?Hive安装1495.2.2 ?Hive的基本操作1555.2.3 ?总结1605.3 ?Hive进阶实践1605.3.1 ?Hive中的表类型1605.3.2 ?使用JavaAPI连接Hive1665.3.3 ?Spark SQL1685.3.4 ?总结1705.4 ?其他常见的数据仓库1705.5 ?总结173第6章 ?大数据技术综合实践1756.1 ?电影评论情感倾向与用户评价关联性初探1776.1.1 ?实验背景1776.1.2 ?实验准备1786.1.3 ?正式开始实验1806.1.4 ?执行程序并分析结果1916.2 ?网站日志信息处理案例1936.2.1 ?实验背景1936.2.2 ?实验准备1946.2.3 ?正式开始实验1956.3 ?总结206附录209附录A ?本书GitHub仓库的说明211附录B ?本书所用服务器配置信息213附录C ?节点在集群中的分布情况215
- 新华一城书集 (微信公众号认证)
- 上海新华书店官方微信书店
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...