商品详情
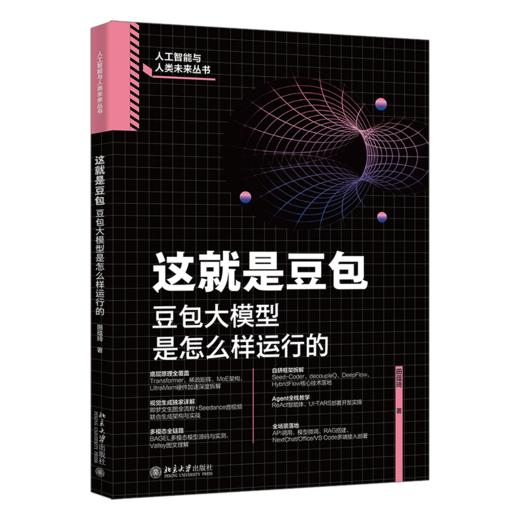
书名:这就是豆包:豆包大模型是怎么样运行的
定价:119.0
ISBN:9787301375846
作者:田蕴琦 著
版次:1
出版时间:2026-08
内容提要:
本书以豆包大模型的技术发展与实践落地为主线,实现了从底层架构到上层应用的全链路覆盖。内容既包含Transformer架构、自注意力机制、MoE架构等核心原理,也涵盖稀疏矩阵优化、UltraMem架构等性能技术,更延伸至语言、视觉、多模态模型的设计与应用,以及强化学习、Agent模型的实践探索,最终落脚于应用程序接口(API)开发、微调部署等实操环节,为读者搭建起“ 原理—架构—优化—应用—落地” 的完整知识网络。
作者简介:
田蕴琦,计算机硕士,百度智能云研发工程师,大模型工程师,在大规模机器学习、深度学习、数据搜索、行业垂直应用、研发管理等领域拥有丰富经验。参与了百度ERNIE 4.5模型的研发工作及该模型在千帆平台的上架事宜,全程参与了其中的模型路由与专家负载失衡设计工作;参与了应用智能体AgentBuilder的研发工作。
目录:
第1章
Transformer基础架构与革新
1.1 Transformer架构概览 2
1.1.1 从RNN/LSTM到自注意力机制的发展 2
1.1.2 Transformer架构的诞生:自注意力机制的集大成者 4
1.1.3 自注意力机制与FFN的原理 5
1.1.4 多头注意力的并行机制 7
1.2 Encoder-Decoder与Decoder-Only架构 8
1.2.1 Encoder-Decoder架构的基本结构和应用 8
1.2.2 Decoder-Only架构:因果语言建模 10
1.2.3 Encoder-Only架构:双向编码 12
1.3 位置编码与注意力优化 14
1.3.1 绝对位置编码与相对位置编码的实现 14
1.3.2 局部注意力与稀疏注意力 16
1.4 豆包大模型与MoE架构 17
1.4.1 MoE架构的核心原理 17
1.4.2 MoE架构的核心组件 18
1.4.3 执行流程 18
1.4.4 权重分配 19
1.4.5 豆包大模型中的MoE架构 20
1.4.6 豆包大模型中MoE架构的关键技术细节 21
第2章
稀疏矩阵和UltraMem架构
2.1 稀疏矩阵基础与存储格式 25
2.1.1 稀疏矩阵定义与应用场景 25
2.1.2 常见的稀疏矩阵存储格式 26
2.1.3 存储格式比较:内存占用与访问效率 35
2.2 稀疏矩阵运算优化技术 36
2.2.1 稀疏矩阵-向量乘法加速策略 36
2.2.2 稀疏矩阵-矩阵乘法并行调度 47
2.3 UltraMem架构概述 48
2.3.1 UltraMem架构的诞生背景 48
2.3.2 UltraMem架构的设计目标与定位 49
2.3.3 UltraMem架构基础 50
2.3.4 UltraMem架构核心 51
2.3.5 UltraMem架构的核心组件:高带宽内存与稀疏加速单元 55
2.4 UltraMem微架构细节 56
2.4.1 稀疏索引压缩策略 56
2.4.2 流水线设计与并行调度机制 58
2.4.3 低精度算术与量化技术 59
第3章
基础语言模型的核心架构与应用
3.1 豆包语言模型核心技术与创新 62
3.1.1 模型的参数规模 62
3.1.2 优化策略与训练加速 63
3.2 Seed-Coder开源模型介绍与使用 64
3.2.1 背景介绍 64
3.2.2 预训练 65
3.2.3 训练后处理 71
3.2.4 基础模型评估 75
3.2.5 Seed-Coder开源模型实践 75
3.3 分片数据并行优化 79
3.3.1 具体技术细节 80
3.3.2 NVIDIA Megatron-LM框架介绍 82
3.3.3 核心框架层:Megatron-LM基础架构 83
3.3.4 数据处理层:输入与预处理 112
3.3.5 模型实现层:基础模型与量化优化 113
3.3.6 优化器与训练逻辑 119
3.3.7 预训练与微调 129
3.3.8 预训练主程序 132
3.3.9 SDP4Bit项目之于豆包大模型的价值总结 133
3.4 后训练均匀量化 134
3.4.1 decoupleQ项目介绍 134
3.4.2 decoupleQ项目对豆包大模型的影响 135
第4章
视觉图像模型的核心架构与应用
4.1 豆包视觉图像模型的核心技术与创新 138
4.1.1 基于扩散模型的图像生成架构 138
4.1.2 高分辨率图像生成优化 139
4.2 图像风格迁移与转换 141
4.2.1 系统配置 142
4.2.2 工具模块 145
4.2.3 自定义流水线 148
4.2.4 采样器优化 153
4.2.5 重噪声反演算法 153
4.2.6 图像修复 159
4.2.7 图像风格迁移 173
4.3 文生图大模型应用和即梦AI 177
4.3.1 系统配置 177
4.3.2 模型实现 180
4.3.3 扩散模型调度器 182
4.3.4 文生图 195
4.3.5 Web测试 196
4.3.6 调试运行 199
4.4 DeepFlow深度监督和加速机制 200
4.4.1 DeepFlow介绍 200
4.4.2 DeepFlow对豆包大模型的影响 202
第5章
多模态模型的核心架构与应用
5.1 豆包开源多模态模型核心技术与创新 206
5.1.1 豆包多模态融合架构设计 206
5.1.2 豆包多模态大模型的预训练任务体系与数据策略 207
5.2 多模态基础模型BAGEL 209
5.2.1 技术架构与突破 209
5.2.2 数据处理 210
5.2.3 多模态模型架构:从宏观到微观 217
5.2.4 训练机制:从配置到实现 232
5.2.5 模型评估与基准测试 244
5.2.6 进阶功能:扩展与优化 267
5.2.7 BAGEL-7B-MoT多模态模型的推理测试 272
5.2.8 Web入口文件 285
5.3 多模态基础模型Valley 289
5.3.1 Valley 2.0的优势与特色详解 289
5.3.2 多图像理解测试 290
5.3.3 视频理解测试 292
第6章
强化学习和推理?
6.1 Seed-Thinking模型 295
6.1.1 背景介绍 295
6.1.2 数据组成 297
6.1.3 奖励建模 299
6.1.4 具体方法 301
6.1.5 模型训练 303
6.1.6 评估结果 304
6.2 HybridFlow框架 306
6.2.1 RLHF介绍 306
6.2.2 HybridFlow框架的诞生背景 307
6.2.3 HybridFlow框架原理详解 309
6.3 HybridFlow框架源码分析 312
6.3.1 模型架构 312
6.3.2 训练算法 335
6.3.3 任务执行 349
6.3.4 训练 DeepSeek模型 349
6.3.5 训练Qwen2模型 352
第7章
豆包Agent的核心架构与应用
7.1 豆包Agent核心技术与创新 355
7.2 豆包Agent开源项目源码解析 356
7.2.1 核心功能介绍 356
7.2.2 准备数据 357
7.2.3 指令解析 359
7.2.4 提示模板 371
7.2.5 操作解析测试 373
7.2.6 推理测试 374
7.2.7 UI-TARS模型部署与测试 376
第8章
豆包大模型应用开发实践?
8.1 豆包API开发 381
8.1.1 获取API Key 381
8.1.2 基于豆包API的基本对话程序 384
8.1.3 基于豆包API的文生图程序 389
8.2 微调和预训练 395
8.2.1 数据准备与清洗 395
8.2.2 豆包预训练模型调用实战 403
8.2.3 豆包预训练模型微调实战 407
8.2.4 基于微调大模型的推理实战 411
8.3 RAG搭建 413
8.3.1 RAG概述 414
8.3.2 RAG的架构 415
8.3.3 基于本地豆包大模型的RAG系统 416
第9章
豆包大模型的部署和接入?
9.1 接入前的准备 424
9.2 Chatbox接入 424
9.2.1 安装Chatbox 424
9.2.2 接入Chatbox 425
9.3 NextChat接入实战 427
9.3.1 NextChat的主要功能 427
9.3.2 运行本地源代码 428
9.3.3 本地安装NextChat 428
9.4 通过OfficeAI助手将豆包大模型接入Office 431
9.4.1 OfficeAI助手功能介绍 431
9.4.2 下载并安装OfficeAI助手 431
9.4.3 在Word中应用豆包大模型 432
9.4.4 在Excel中应用豆包大模型 434
9.5 将豆包大模型接入VS Code 436
9.5.1 安装Trae AI 436
9.5.2 调用豆包大模型生成代码 437
9.5.3 调用豆包大模型实现代码的解释和注释 438
9.6 将豆包大模型接入PyCharm 439
9.6.1 为PyCharm安装Trae AI 440
9.6.2 配置豆包大模型 442
定价:119.0
ISBN:9787301375846
作者:田蕴琦 著
版次:1
出版时间:2026-08
内容提要:
本书以豆包大模型的技术发展与实践落地为主线,实现了从底层架构到上层应用的全链路覆盖。内容既包含Transformer架构、自注意力机制、MoE架构等核心原理,也涵盖稀疏矩阵优化、UltraMem架构等性能技术,更延伸至语言、视觉、多模态模型的设计与应用,以及强化学习、Agent模型的实践探索,最终落脚于应用程序接口(API)开发、微调部署等实操环节,为读者搭建起“ 原理—架构—优化—应用—落地” 的完整知识网络。
作者简介:
田蕴琦,计算机硕士,百度智能云研发工程师,大模型工程师,在大规模机器学习、深度学习、数据搜索、行业垂直应用、研发管理等领域拥有丰富经验。参与了百度ERNIE 4.5模型的研发工作及该模型在千帆平台的上架事宜,全程参与了其中的模型路由与专家负载失衡设计工作;参与了应用智能体AgentBuilder的研发工作。
目录:
第1章
Transformer基础架构与革新
1.1 Transformer架构概览 2
1.1.1 从RNN/LSTM到自注意力机制的发展 2
1.1.2 Transformer架构的诞生:自注意力机制的集大成者 4
1.1.3 自注意力机制与FFN的原理 5
1.1.4 多头注意力的并行机制 7
1.2 Encoder-Decoder与Decoder-Only架构 8
1.2.1 Encoder-Decoder架构的基本结构和应用 8
1.2.2 Decoder-Only架构:因果语言建模 10
1.2.3 Encoder-Only架构:双向编码 12
1.3 位置编码与注意力优化 14
1.3.1 绝对位置编码与相对位置编码的实现 14
1.3.2 局部注意力与稀疏注意力 16
1.4 豆包大模型与MoE架构 17
1.4.1 MoE架构的核心原理 17
1.4.2 MoE架构的核心组件 18
1.4.3 执行流程 18
1.4.4 权重分配 19
1.4.5 豆包大模型中的MoE架构 20
1.4.6 豆包大模型中MoE架构的关键技术细节 21
第2章
稀疏矩阵和UltraMem架构
2.1 稀疏矩阵基础与存储格式 25
2.1.1 稀疏矩阵定义与应用场景 25
2.1.2 常见的稀疏矩阵存储格式 26
2.1.3 存储格式比较:内存占用与访问效率 35
2.2 稀疏矩阵运算优化技术 36
2.2.1 稀疏矩阵-向量乘法加速策略 36
2.2.2 稀疏矩阵-矩阵乘法并行调度 47
2.3 UltraMem架构概述 48
2.3.1 UltraMem架构的诞生背景 48
2.3.2 UltraMem架构的设计目标与定位 49
2.3.3 UltraMem架构基础 50
2.3.4 UltraMem架构核心 51
2.3.5 UltraMem架构的核心组件:高带宽内存与稀疏加速单元 55
2.4 UltraMem微架构细节 56
2.4.1 稀疏索引压缩策略 56
2.4.2 流水线设计与并行调度机制 58
2.4.3 低精度算术与量化技术 59
第3章
基础语言模型的核心架构与应用
3.1 豆包语言模型核心技术与创新 62
3.1.1 模型的参数规模 62
3.1.2 优化策略与训练加速 63
3.2 Seed-Coder开源模型介绍与使用 64
3.2.1 背景介绍 64
3.2.2 预训练 65
3.2.3 训练后处理 71
3.2.4 基础模型评估 75
3.2.5 Seed-Coder开源模型实践 75
3.3 分片数据并行优化 79
3.3.1 具体技术细节 80
3.3.2 NVIDIA Megatron-LM框架介绍 82
3.3.3 核心框架层:Megatron-LM基础架构 83
3.3.4 数据处理层:输入与预处理 112
3.3.5 模型实现层:基础模型与量化优化 113
3.3.6 优化器与训练逻辑 119
3.3.7 预训练与微调 129
3.3.8 预训练主程序 132
3.3.9 SDP4Bit项目之于豆包大模型的价值总结 133
3.4 后训练均匀量化 134
3.4.1 decoupleQ项目介绍 134
3.4.2 decoupleQ项目对豆包大模型的影响 135
第4章
视觉图像模型的核心架构与应用
4.1 豆包视觉图像模型的核心技术与创新 138
4.1.1 基于扩散模型的图像生成架构 138
4.1.2 高分辨率图像生成优化 139
4.2 图像风格迁移与转换 141
4.2.1 系统配置 142
4.2.2 工具模块 145
4.2.3 自定义流水线 148
4.2.4 采样器优化 153
4.2.5 重噪声反演算法 153
4.2.6 图像修复 159
4.2.7 图像风格迁移 173
4.3 文生图大模型应用和即梦AI 177
4.3.1 系统配置 177
4.3.2 模型实现 180
4.3.3 扩散模型调度器 182
4.3.4 文生图 195
4.3.5 Web测试 196
4.3.6 调试运行 199
4.4 DeepFlow深度监督和加速机制 200
4.4.1 DeepFlow介绍 200
4.4.2 DeepFlow对豆包大模型的影响 202
第5章
多模态模型的核心架构与应用
5.1 豆包开源多模态模型核心技术与创新 206
5.1.1 豆包多模态融合架构设计 206
5.1.2 豆包多模态大模型的预训练任务体系与数据策略 207
5.2 多模态基础模型BAGEL 209
5.2.1 技术架构与突破 209
5.2.2 数据处理 210
5.2.3 多模态模型架构:从宏观到微观 217
5.2.4 训练机制:从配置到实现 232
5.2.5 模型评估与基准测试 244
5.2.6 进阶功能:扩展与优化 267
5.2.7 BAGEL-7B-MoT多模态模型的推理测试 272
5.2.8 Web入口文件 285
5.3 多模态基础模型Valley 289
5.3.1 Valley 2.0的优势与特色详解 289
5.3.2 多图像理解测试 290
5.3.3 视频理解测试 292
第6章
强化学习和推理?
6.1 Seed-Thinking模型 295
6.1.1 背景介绍 295
6.1.2 数据组成 297
6.1.3 奖励建模 299
6.1.4 具体方法 301
6.1.5 模型训练 303
6.1.6 评估结果 304
6.2 HybridFlow框架 306
6.2.1 RLHF介绍 306
6.2.2 HybridFlow框架的诞生背景 307
6.2.3 HybridFlow框架原理详解 309
6.3 HybridFlow框架源码分析 312
6.3.1 模型架构 312
6.3.2 训练算法 335
6.3.3 任务执行 349
6.3.4 训练 DeepSeek模型 349
6.3.5 训练Qwen2模型 352
第7章
豆包Agent的核心架构与应用
7.1 豆包Agent核心技术与创新 355
7.2 豆包Agent开源项目源码解析 356
7.2.1 核心功能介绍 356
7.2.2 准备数据 357
7.2.3 指令解析 359
7.2.4 提示模板 371
7.2.5 操作解析测试 373
7.2.6 推理测试 374
7.2.7 UI-TARS模型部署与测试 376
第8章
豆包大模型应用开发实践?
8.1 豆包API开发 381
8.1.1 获取API Key 381
8.1.2 基于豆包API的基本对话程序 384
8.1.3 基于豆包API的文生图程序 389
8.2 微调和预训练 395
8.2.1 数据准备与清洗 395
8.2.2 豆包预训练模型调用实战 403
8.2.3 豆包预训练模型微调实战 407
8.2.4 基于微调大模型的推理实战 411
8.3 RAG搭建 413
8.3.1 RAG概述 414
8.3.2 RAG的架构 415
8.3.3 基于本地豆包大模型的RAG系统 416
第9章
豆包大模型的部署和接入?
9.1 接入前的准备 424
9.2 Chatbox接入 424
9.2.1 安装Chatbox 424
9.2.2 接入Chatbox 425
9.3 NextChat接入实战 427
9.3.1 NextChat的主要功能 427
9.3.2 运行本地源代码 428
9.3.3 本地安装NextChat 428
9.4 通过OfficeAI助手将豆包大模型接入Office 431
9.4.1 OfficeAI助手功能介绍 431
9.4.2 下载并安装OfficeAI助手 431
9.4.3 在Word中应用豆包大模型 432
9.4.4 在Excel中应用豆包大模型 434
9.5 将豆包大模型接入VS Code 436
9.5.1 安装Trae AI 436
9.5.2 调用豆包大模型生成代码 437
9.5.3 调用豆包大模型实现代码的解释和注释 438
9.6 将豆包大模型接入PyCharm 439
9.6.1 为PyCharm安装Trae AI 440
9.6.2 配置豆包大模型 442
- 北京大学出版社旗舰店 (微信公众号认证)
- 【发票】在订单留言电子邮箱、发票抬头、税号、(统一开电子发票,缺一项都不能开票,自行下载打印)
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...