商品详情
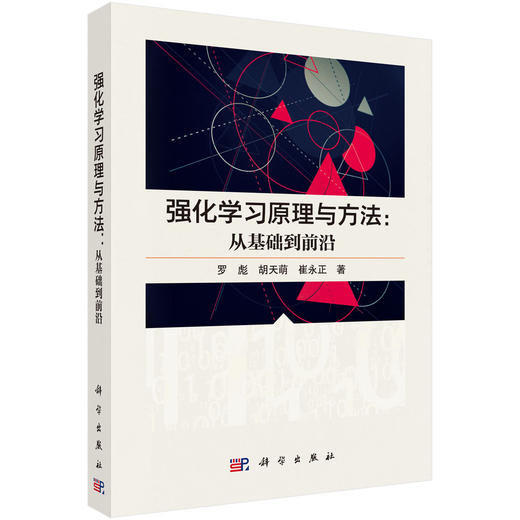
书名:强化学习原理与方法:从基础到前沿
定价:198.0
ISBN:9787030855787
作者:罗彪,胡天萌,崔永正
版次:1
出版时间:2026-04
内容提要:
目录:
目录
前言
常用符号
第1章 绪论 1
1.1 人工智能 1
1.1.1 什么是智能? 1
1.1.2 人工智能与人类智能 2
1.1.3 监督学习、非监督学习与强化学习 3
1.1.4 小结 4
1.2 强化学习 4
1.2.1 乌鸦的试错:动物智能的启示 4
1.2.2 强化学习的基本框架 6
1.2.3 强化学习的发展历史 6
1.2.4 强化学习的应用与展望 7
第一部分 强化学习基础
第2章 马尔可夫决策过程 11
2.1 马尔可夫过程 11
2.1.1 随机过程与状态空间 11
2.1.2 状态转移概率 12
2.1.3 马尔可夫性质 12
2.1.4 示例:简单网格世界 12
2.2 马尔可夫奖励过程 18
2.2.1 奖励与回报 18
2.2.2 折扣因子的影响 26
2.2.3 状态值函数与贝尔曼期望方程 26
2.3 马尔可夫决策过程 31
2.3.1 智能体-环境交互 31
2.3.2 策略 43
2.3.3 状态-动作值函数与贝尔曼方程 49
2.3.4 贝尔曼…方程 54
第3章 强化学习中的基本问题 56
3.1 规划与学习 56
3.1.1 环境模型 56
3.1.2 有环境模型:规划 57
3.1.3 无环境模型:学习 58
3.1.4 规划与学习的对立与统一 59
3.2 预测与控制 60
3.2.1 预测 60
3.2.2 控制 61
3.3 探索与利用 63
3.3.1 强化学习中的探索 63
3.3.2 探索与利用的平衡 64
3.3.3 多臂赌博机 64
第4章 有模型:动态规划 78
4.1 策略迭代 83
4.1.1 策略评估 83
4.1.2 策略改进 85
4.1.3 代码实现 87
4.2 价值迭代 92
4.3 广义策略迭代 98
4.4 收敛性证明 99
4.4.1 压缩映射定理 99
4.4.2 策略迭代的收敛性证明 100
4.4.3 价值迭代的收敛性证明 102
第5章 函数逼近 104
5.1 函数逼近在强化学习中的作用 104
5.1.1 值函数逼近 104
5.1.2 策略逼近 105
5.1.3 小结 106
5.2 函数逼近方法 106
5.2.1 线性函数逼近 106
5.2.2 神经网络逼近 108
5.2.3 卷积神经网络 113
5.2.4 循环神经网络 114
5.2.5 其他函数逼近类型 115
第6章 值函数强化学习方法 120
6.1 无模型问题 120
6.2 蒙特卡罗方法 121
6.3 时序差分方法 125
6.4 SARSA算法 127
6.4.1 表格SARSA算法原理 128
6.4.2 SARSA算法实践 129
6.5 Q-Learning算法 134
6.5.1 Q-Learning算法原理 134
6.5.2 Q-Learning算法实践 135
6.6 DQN算法 138
6.6.1 DQN算法原理 138
6.6.2 经验回放机制 139
6.6.3 时序差分损失 140
6.6.4 DQN算法实践 141
6.7 Double DQN 151
6.7.1 Q值的高估问题 151
6.7.2 Target网络 152
6.7.3 Double DQN原理 153
6.7.4 Double DQN实践 154
6.8 Dueling DQN 159
6.8.1 状态价值与动作优势价值 159
6.8.2 Dueling DQN原理 160
6.8.3 Dueling DQN实践 161
第7章 策略梯度强化学习方法 167
7.1 策略梯度定理 167
7.1.1 策略网络 167
7.1.2 策略学习 167
7.1.3 策略梯度定理推导 169
7.2 REINFORCE算法 171
7.2.1 算法原理 172
7.2.2 算法实践 173
7.2.3 算法分析 175
7.3 Actor-Critic算法 176
7.3.1 算法原理 177
7.3.2 Advantage Actor-Critic 180
7.3.3 算法实践 182
7.4 TRPO算法 188
7.4.1 简介 188
7.4.2 算法原理 188
7.4.3 理论推导 191
7.4.4 广义优势估计 193
7.4.5 算法实践 194
7.5 PPO算法 200
7.5.1 简介 200
7.5.2 惩罚形式的PPO 201
7.5.3 截断形式的PPO 201
7.5.4 算法实践 202
7.6 DDPG算法 212
7.6.1 算法简介 212
7.6.2 算法原理 213
7.6.3 算法实践 214
第二部分 强化学习研究
第8章 探索与奖励 221
8.1 经典探索机制 221
8.1.1 ε-greedy机制 221
8.1.2 玻尔兹曼探索 223
8.1.3 基于噪声的探索 225
8.1.4 基于策略熵的探索 228
8.2 基于内在奖励的探索机制 230
8.2.1 基于计数的探索 231
8.2.2 基于伪计数的探索 232
8.2.3 基于预测的探索 234
8.3 记忆机制 238
第9章 多智能体强化学习 241
9.1 多智能体强化学习基础 242
9.1.1 分布部分可观测马尔可夫决策过程 242
9.1.2 中心化训练与中心化执行 243
9.1.3 分散化训练与分散化执行 243
9.1.4 中心化训练与分散化执行 244
9.2 仿真环境 244
9.2.1 星际争霸2微观管理挑战 245
9.2.2 谷歌足球 246
9.2.3 多粒子环境 247
9.3 基于值分解的多智能体强化学习方法 247
9.3.1 IGM原则 248
9.3.2 有约束价值函数分解 248
9.3.3 无约束价值分解 251
9.4 基于策略梯度的多智能体强化学习方法 253
9.4.1 分布式Actor-Critic设计 253
9.4.2 集中式Critic设计 256
9.4.3 参数共享的Actor-Critic设计 256
9.4.4 策略优化 257
第10章 多目标/多任务强化学习 262
10.1 多目标优化基础 262
10.1.1 多目标优化问题 262
10.1.2 帕累托…性 263
10.1.3 非支配排序 264
10.2 多目标强化学习 267
10.2.1 多目标决策问题 267
10.2.2 帕累托策略集 268
10.2.3 评估多目标算法的性能 270
10.2.4 多目标问题的分解 273
10.2.5 多目标强化学习前沿 275
10.3 多任务强化学习 279
10.3.1 多任务学习问题 279
10.3.2 学习共享知识 281
10.3.3 策略蒸馏与知识迁移 282
第11章 人在回路强化学习 284
11.1 模仿学习 284
11.1.1 模仿学习基础 285
11.1.2 行为克隆 285
11.1.3 逆强化学习 286
11.1.4 生成对抗模仿学习 286
11.2 偏好学习 287
11.2.1 偏好学习基础 288
11.2.2 偏好策略学习 290
11.2.3 偏好效用学习 293
第三部分 强化学习应用
第12章 围棋 299
12.1 完全信息博弈 299
12.2 围棋中的挑战 300
12.3 AlphaGo 301
12.3.1 AlphaGo的整体思路 301
12.3.2 问题定义 303
12.3.3 策略网络的预训练 303
12.3.4 策略网络的强化学习训练 305
12.3.5 价值网络的强化学习训练 306
12.3.6 蒙特卡罗树搜索 307
12.4 AlphaGo Zero: 自博弈 310
12.4.1 策略网络与价值网络的统一 310
12.4.2 改进的蒙特卡罗树搜索 312
12.4.3 基于强化学习的自博弈 314
第13章 星际争霸2: 复杂战略决策 317
13.1 问题与难点 317
13.2 AlphaStar 318
13.2.1 核心思想与主要成就 318
13.2.2 环境设计 318
13.2.3 网络结构 321
13.2.4 训练过程 322
第14章 大语言模型 327
14.1 大语言模型背景与现状 327
14.2 ChatGPT 328
14.2.1 预训练 328
14.2.2 监督微调 328
14.2.3 基于人类反馈的强化学习微调 329
14.3 DeepSeek 329
14.3.1 奖励机制设计 330
14.3.2 组相对策略优化: GRPO 331
14.3.3 DeepSeek-R1-Zero 333
14.3.4 DeepSeek-R1 334
第15章 计算蛋白质设计 338
15.1 蛋白质结构设计 338
15.2 基于强化学习的自顶向下设计 339
15.2.1 方法概述 339
15.2.2 决策树 340
15.2.3 扩展与评估 341
15.2.4 几何约束 342
15.2.5 权重上调 343
15.3 本章小结 344
第16章 无人机飞行控制 345
16.1 问题与难点 345
16.2 基于强化学习的无人机飞行控制方法 346
16.2.1 问题定义 346
16.2.2 优化目标 347
16.2.3 环境设计 347
16.2.4 策略训练 349
16.2.5 仿真到真实的迁移 349
16.2.6 飞行效果 350
16.3 本章小结 351
参考文献 352
彩图
定价:198.0
ISBN:9787030855787
作者:罗彪,胡天萌,崔永正
版次:1
出版时间:2026-04
内容提要:
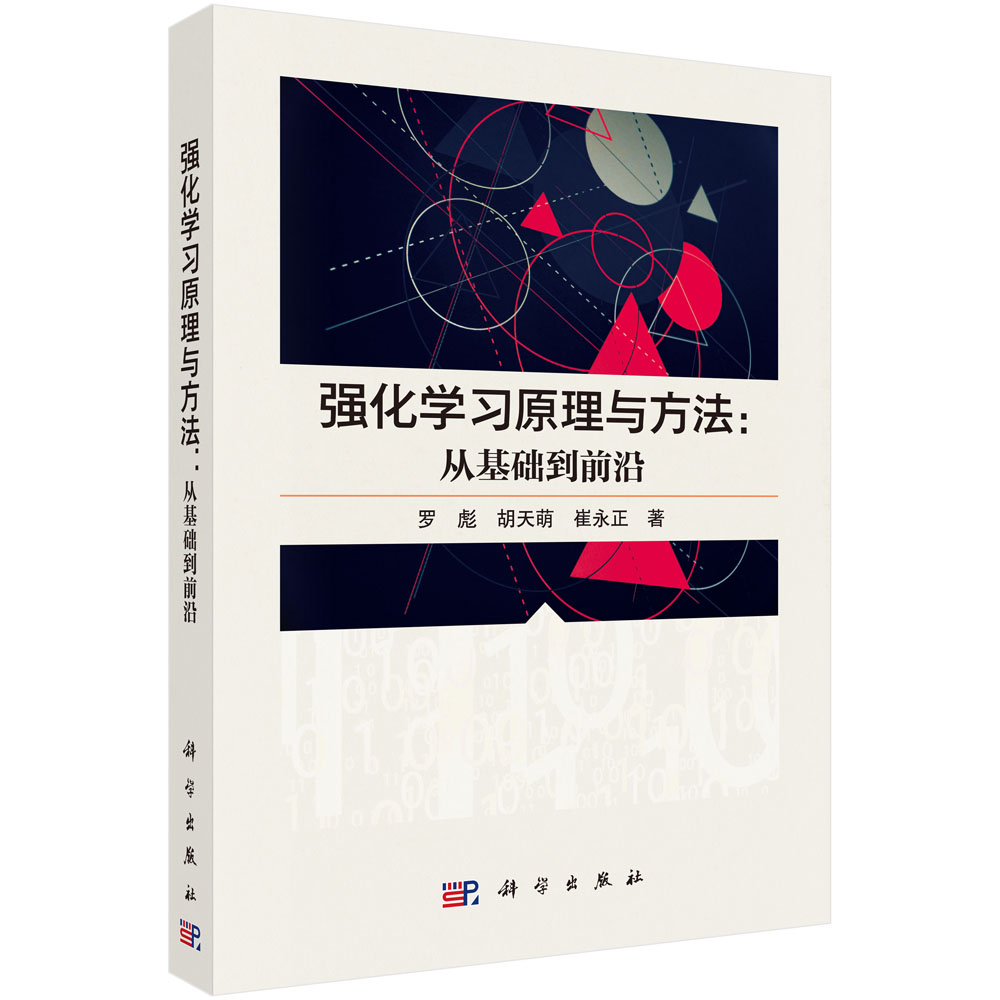
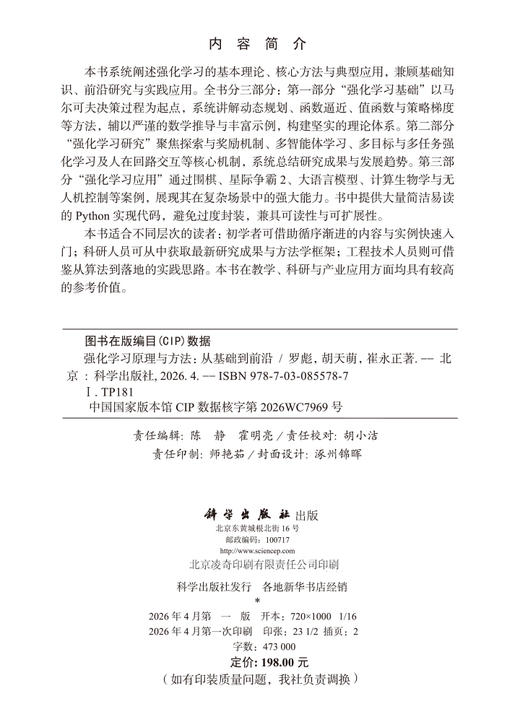
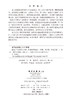
本书系统阐述强化学习的基本理论、核心方法与典型应用,兼顾基础知识、前沿研究与实践应用。全书分三部分:第一部分“强化学习基础”以马尔可夫决策过程为起点,系统讲解动态规划、函数逼近、值函数与策略梯度等方法,辅以严谨的数学推导与丰富示例,构建坚实的理论体系。第二部分“强化学习研究”聚焦探索与奖励机制、多智能体学习、多目标与多任务强化学习及人在回路交互等核心机制,系统总结研究成果与发展趋势。第三部分“强化学习应用”通过围棋、星际争霸2、大语言模型、计算生物学与无人机控制等案例,展现其在复杂场景中的强大能力。书中提供大量简洁易读的 Python实现代码,避免过度封装,兼具可读性与可扩展性。
目录:
目录
前言
常用符号
第1章 绪论 1
1.1 人工智能 1
1.1.1 什么是智能? 1
1.1.2 人工智能与人类智能 2
1.1.3 监督学习、非监督学习与强化学习 3
1.1.4 小结 4
1.2 强化学习 4
1.2.1 乌鸦的试错:动物智能的启示 4
1.2.2 强化学习的基本框架 6
1.2.3 强化学习的发展历史 6
1.2.4 强化学习的应用与展望 7
第一部分 强化学习基础
第2章 马尔可夫决策过程 11
2.1 马尔可夫过程 11
2.1.1 随机过程与状态空间 11
2.1.2 状态转移概率 12
2.1.3 马尔可夫性质 12
2.1.4 示例:简单网格世界 12
2.2 马尔可夫奖励过程 18
2.2.1 奖励与回报 18
2.2.2 折扣因子的影响 26
2.2.3 状态值函数与贝尔曼期望方程 26
2.3 马尔可夫决策过程 31
2.3.1 智能体-环境交互 31
2.3.2 策略 43
2.3.3 状态-动作值函数与贝尔曼方程 49
2.3.4 贝尔曼…方程 54
第3章 强化学习中的基本问题 56
3.1 规划与学习 56
3.1.1 环境模型 56
3.1.2 有环境模型:规划 57
3.1.3 无环境模型:学习 58
3.1.4 规划与学习的对立与统一 59
3.2 预测与控制 60
3.2.1 预测 60
3.2.2 控制 61
3.3 探索与利用 63
3.3.1 强化学习中的探索 63
3.3.2 探索与利用的平衡 64
3.3.3 多臂赌博机 64
第4章 有模型:动态规划 78
4.1 策略迭代 83
4.1.1 策略评估 83
4.1.2 策略改进 85
4.1.3 代码实现 87
4.2 价值迭代 92
4.3 广义策略迭代 98
4.4 收敛性证明 99
4.4.1 压缩映射定理 99
4.4.2 策略迭代的收敛性证明 100
4.4.3 价值迭代的收敛性证明 102
第5章 函数逼近 104
5.1 函数逼近在强化学习中的作用 104
5.1.1 值函数逼近 104
5.1.2 策略逼近 105
5.1.3 小结 106
5.2 函数逼近方法 106
5.2.1 线性函数逼近 106
5.2.2 神经网络逼近 108
5.2.3 卷积神经网络 113
5.2.4 循环神经网络 114
5.2.5 其他函数逼近类型 115
第6章 值函数强化学习方法 120
6.1 无模型问题 120
6.2 蒙特卡罗方法 121
6.3 时序差分方法 125
6.4 SARSA算法 127
6.4.1 表格SARSA算法原理 128
6.4.2 SARSA算法实践 129
6.5 Q-Learning算法 134
6.5.1 Q-Learning算法原理 134
6.5.2 Q-Learning算法实践 135
6.6 DQN算法 138
6.6.1 DQN算法原理 138
6.6.2 经验回放机制 139
6.6.3 时序差分损失 140
6.6.4 DQN算法实践 141
6.7 Double DQN 151
6.7.1 Q值的高估问题 151
6.7.2 Target网络 152
6.7.3 Double DQN原理 153
6.7.4 Double DQN实践 154
6.8 Dueling DQN 159
6.8.1 状态价值与动作优势价值 159
6.8.2 Dueling DQN原理 160
6.8.3 Dueling DQN实践 161
第7章 策略梯度强化学习方法 167
7.1 策略梯度定理 167
7.1.1 策略网络 167
7.1.2 策略学习 167
7.1.3 策略梯度定理推导 169
7.2 REINFORCE算法 171
7.2.1 算法原理 172
7.2.2 算法实践 173
7.2.3 算法分析 175
7.3 Actor-Critic算法 176
7.3.1 算法原理 177
7.3.2 Advantage Actor-Critic 180
7.3.3 算法实践 182
7.4 TRPO算法 188
7.4.1 简介 188
7.4.2 算法原理 188
7.4.3 理论推导 191
7.4.4 广义优势估计 193
7.4.5 算法实践 194
7.5 PPO算法 200
7.5.1 简介 200
7.5.2 惩罚形式的PPO 201
7.5.3 截断形式的PPO 201
7.5.4 算法实践 202
7.6 DDPG算法 212
7.6.1 算法简介 212
7.6.2 算法原理 213
7.6.3 算法实践 214
第二部分 强化学习研究
第8章 探索与奖励 221
8.1 经典探索机制 221
8.1.1 ε-greedy机制 221
8.1.2 玻尔兹曼探索 223
8.1.3 基于噪声的探索 225
8.1.4 基于策略熵的探索 228
8.2 基于内在奖励的探索机制 230
8.2.1 基于计数的探索 231
8.2.2 基于伪计数的探索 232
8.2.3 基于预测的探索 234
8.3 记忆机制 238
第9章 多智能体强化学习 241
9.1 多智能体强化学习基础 242
9.1.1 分布部分可观测马尔可夫决策过程 242
9.1.2 中心化训练与中心化执行 243
9.1.3 分散化训练与分散化执行 243
9.1.4 中心化训练与分散化执行 244
9.2 仿真环境 244
9.2.1 星际争霸2微观管理挑战 245
9.2.2 谷歌足球 246
9.2.3 多粒子环境 247
9.3 基于值分解的多智能体强化学习方法 247
9.3.1 IGM原则 248
9.3.2 有约束价值函数分解 248
9.3.3 无约束价值分解 251
9.4 基于策略梯度的多智能体强化学习方法 253
9.4.1 分布式Actor-Critic设计 253
9.4.2 集中式Critic设计 256
9.4.3 参数共享的Actor-Critic设计 256
9.4.4 策略优化 257
第10章 多目标/多任务强化学习 262
10.1 多目标优化基础 262
10.1.1 多目标优化问题 262
10.1.2 帕累托…性 263
10.1.3 非支配排序 264
10.2 多目标强化学习 267
10.2.1 多目标决策问题 267
10.2.2 帕累托策略集 268
10.2.3 评估多目标算法的性能 270
10.2.4 多目标问题的分解 273
10.2.5 多目标强化学习前沿 275
10.3 多任务强化学习 279
10.3.1 多任务学习问题 279
10.3.2 学习共享知识 281
10.3.3 策略蒸馏与知识迁移 282
第11章 人在回路强化学习 284
11.1 模仿学习 284
11.1.1 模仿学习基础 285
11.1.2 行为克隆 285
11.1.3 逆强化学习 286
11.1.4 生成对抗模仿学习 286
11.2 偏好学习 287
11.2.1 偏好学习基础 288
11.2.2 偏好策略学习 290
11.2.3 偏好效用学习 293
第三部分 强化学习应用
第12章 围棋 299
12.1 完全信息博弈 299
12.2 围棋中的挑战 300
12.3 AlphaGo 301
12.3.1 AlphaGo的整体思路 301
12.3.2 问题定义 303
12.3.3 策略网络的预训练 303
12.3.4 策略网络的强化学习训练 305
12.3.5 价值网络的强化学习训练 306
12.3.6 蒙特卡罗树搜索 307
12.4 AlphaGo Zero: 自博弈 310
12.4.1 策略网络与价值网络的统一 310
12.4.2 改进的蒙特卡罗树搜索 312
12.4.3 基于强化学习的自博弈 314
第13章 星际争霸2: 复杂战略决策 317
13.1 问题与难点 317
13.2 AlphaStar 318
13.2.1 核心思想与主要成就 318
13.2.2 环境设计 318
13.2.3 网络结构 321
13.2.4 训练过程 322
第14章 大语言模型 327
14.1 大语言模型背景与现状 327
14.2 ChatGPT 328
14.2.1 预训练 328
14.2.2 监督微调 328
14.2.3 基于人类反馈的强化学习微调 329
14.3 DeepSeek 329
14.3.1 奖励机制设计 330
14.3.2 组相对策略优化: GRPO 331
14.3.3 DeepSeek-R1-Zero 333
14.3.4 DeepSeek-R1 334
第15章 计算蛋白质设计 338
15.1 蛋白质结构设计 338
15.2 基于强化学习的自顶向下设计 339
15.2.1 方法概述 339
15.2.2 决策树 340
15.2.3 扩展与评估 341
15.2.4 几何约束 342
15.2.5 权重上调 343
15.3 本章小结 344
第16章 无人机飞行控制 345
16.1 问题与难点 345
16.2 基于强化学习的无人机飞行控制方法 346
16.2.1 问题定义 346
16.2.2 优化目标 347
16.2.3 环境设计 347
16.2.4 策略训练 349
16.2.5 仿真到真实的迁移 349
16.2.6 飞行效果 350
16.3 本章小结 351
参考文献 352
彩图
- 科学出版社旗舰店 (微信公众号认证)
- 科学出版社秉承多年来形成的“高层次、高水平、高质量”和“严肃、严密、严格”的优良传统与作风,始终坚持为科技创新服务、为传播与普及科学知识服务、为科学家和广大读者服务的宗旨。
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...