商品详情
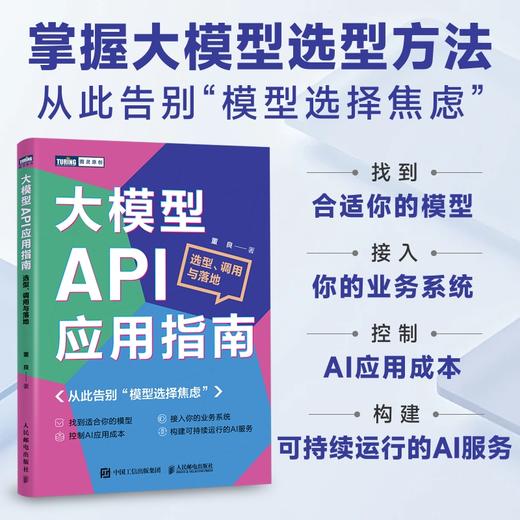
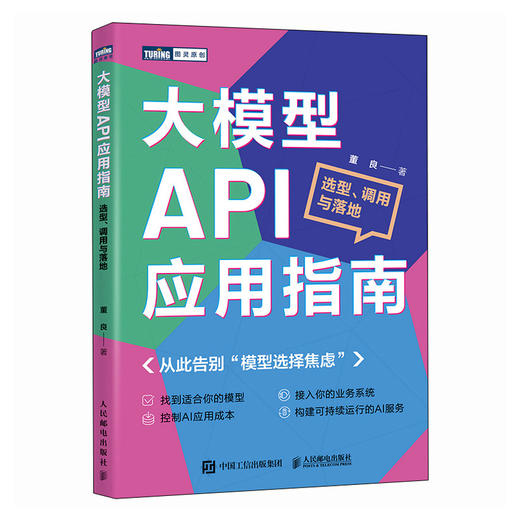
书名:大模型API应用指南:选型、调用与落地
定价:59.8
ISBN:9787115704979
作者:董良
版次:第1版
出版时间:2026-08
内容提要:
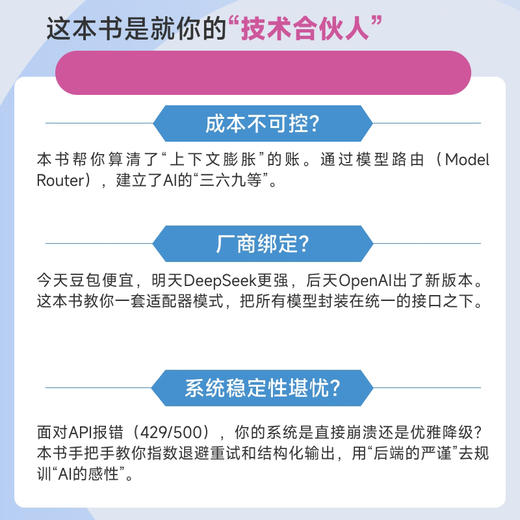
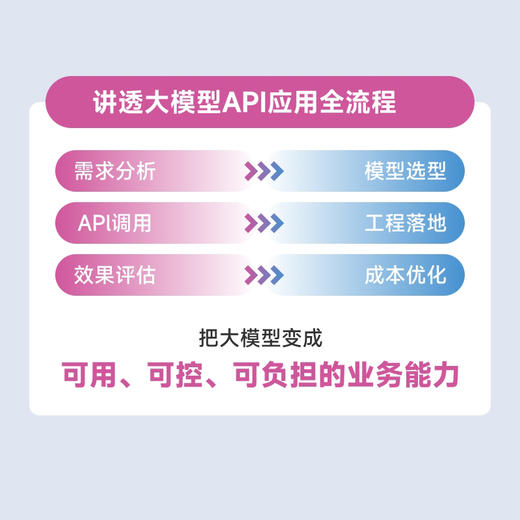
本书是一本聚焦大模型API工程落地的实战指南。全书从认知、选型、调用、集成到私有化部署,系统讲解如何跨越Demo与生产环境之间的鸿沟。内容包括:业务需求判断与ROI测算、模型分级与路由策略、上下文窗口陷阱与记忆管理、结构化输出与适配器模式、本地部署与量化压缩等。本书不涉及复杂数学公式,侧重架构决策与成本控制,帮助读者构建稳定、可控、划算的AI应用系统。本书适合AI工程师、技术型产品经理、独立*及传统软件*阅读,也适用于希望建立AI工程化思维的产品经理和技术决策者。
作者简介:
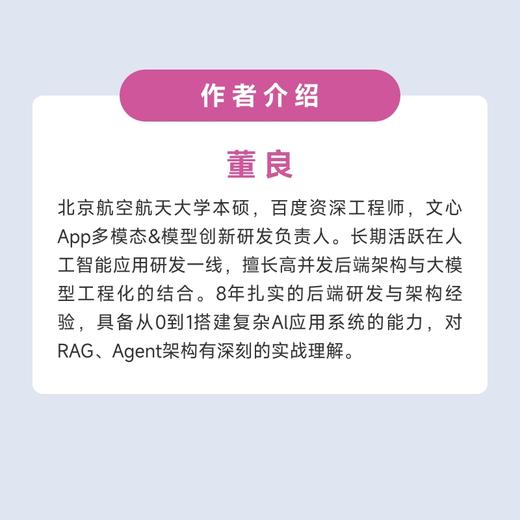
董良,毕业于北京航空航天大学,长期活跃在人工智能应用研发一线,擅长高并发后端架构与大模型工程化(LLM Ops)的结合。在百度文心APP中,负责关键的模型选型策略与多模态技术栈建设,支撑业务的快速迭代与创新。具备从0到1搭建复杂AI应用系统的能力,对RAG、Agent架构有深刻的实战理解。
目录:
前言:跨越“Demo”与“生产环境”的深渊
第 一章 认知——决策先于代码
1.1 你的业务真的需要大模型吗?
1.1.1 逻辑选型的顺序
1.1.2 什么时候*须用LLM?
1.1.3 实战中的多种拼接
1.1.4 本节小结
1.2 算账:看不见的Token
1.2.1 计费单位:Token ≠ 字数
1.2.2 核心陷阱:汉堡包理论
1.2.3 算一笔账:1000个用户的“破产时刻”
1.2.4 本节小结:如何自救?
1.3 选型策略:像CEO一样组建AI团队
1.3.1 你的AI组织架构图
1.3.2 决策表格:一眼看懂ROI
1.3.3 核心架构:模型路由
1.4 本章总结
*章 筛选——大模型“购物指南”
2.1 读懂参数说明书:打破厂商的“数字游戏”
2.1.1 核心单位:它真的不是“字数”
2.1.2 上下文窗口:大*是好?
2.1.3 性能指标:反应快 ≠ 说话快
2.1.4 本节小结
2.2 场景化筛选:拿着锤子找钉子
2.2.1 文本类:分清“文科”与“理科”
2.2.2 视觉理解:不仅仅是“看见”,更是“看懂”
2.2.3 听觉与视频:新维度的竞争
2.3 测试集与榜单:建立你的“黄金测试集”
2.3.1 为什么公开榜单“不可信”?
2.3.2 针对模态的*“面试题库”
2.3.3 构建你的“黄金测试集”
2.3.4 选型决策矩阵
2.4 识破命名游戏:别死记型号,要看“后缀”逻辑
第三章 调用——不仅是API接入
3.1 快速上手:如何“点火”发动模型?
3.2 解剖API请求
3.2.1 痛点:AI为什么总是“出戏”?
3.2.2 原理:Messages列表的三权分立
3.2.3 解决方案:构建*的Context结构
3.3 掌控“温度”:Temperature与采样参数详解
3.3.1 Temperature:概率的“混乱度”开关
3.3.2 Top_p:精简选择的工具
3.3.3 MaxTokens:防止废话与预算*支
3.3.4 Seed:确保一致性
3.4 *体验:为什么AI要像打字机一样一个个蹦字?
3.4.1 痛点:讨厌的“加载中”转圈圈
3.4.2 原理:SSE与TTFT
3.4.3 解决方案:代码实现
3.4.4 实战对比:流式传输的“隐藏坑位”
3.5 生产级稳健性:重试与报错处理
3.5.1 提出问题:API报错了怎么办?
3.5.2 原理/概念:常见错误与指数退避
3.5.3 关键配置详解
3.5.4 真实世界的“翻车案例”
3.6 实战演练
3.6.1 文本创意
3.6.2 图片理解:不仅仅是“看见”,更是“看懂”
3.6.3 视觉生成
3.6.4 视频生成:从“随缘抽卡”到“导演视角”
第四章 集成——多模型接入方案
4.1 构建模型路由中心
4.1.1 实战惨案:被SDK“绑架”的代价
4.1.2 核心三部曲:注册、定位、转换
4.1.3 这种设计的“真香”时刻
4.2 记忆管理
4.2.1 核心痛点:为什么AI像只有七秒记忆的金鱼?
4.2.2 基础策略分析:暴力拼接 vs 滑动窗口
4.2.3 进阶策略:摘要总结与混合索引
4.2.4 成本与性能的平衡
4.3 结构化输出
4.3.1 给模型立规矩:JSON Schema与Function Calling
4.3.2 实战演示:定义“*路由”协议
4.4 本章总结
第五章 展望——私有化和未来
5.1 自行部署方案:为什么要折腾本地版?
5.1.1 显存:AI时代的“硬通货”
5.1.2 量化压缩:牺牲一点“智商”换取速度
5.1.3 TPS:每秒吐字数
5.1.4 架构适配:LLM Adapter的威力
5.2 尝试私有化:小白也能跑通的“Hello World”
5.2.1 极简工具:Ollama,大模型界的“一键安装包”
5.2.2 核心局限:为什么Ollama带不动“高并发”?
5.2.3 升级到生产环境:vLLM
5.2.4 模型选型:Qwen,开源界*香的源神
5.2.5 深度实战:改一行代码,把本地模型变“私有云”
5.3 总结:从入门到进阶
5.3.1 你已经建立的“AI战斗力”
5.3.2 *的建议:务实派的“心法”
5.3.3 结语:恭喜你拿到了船票 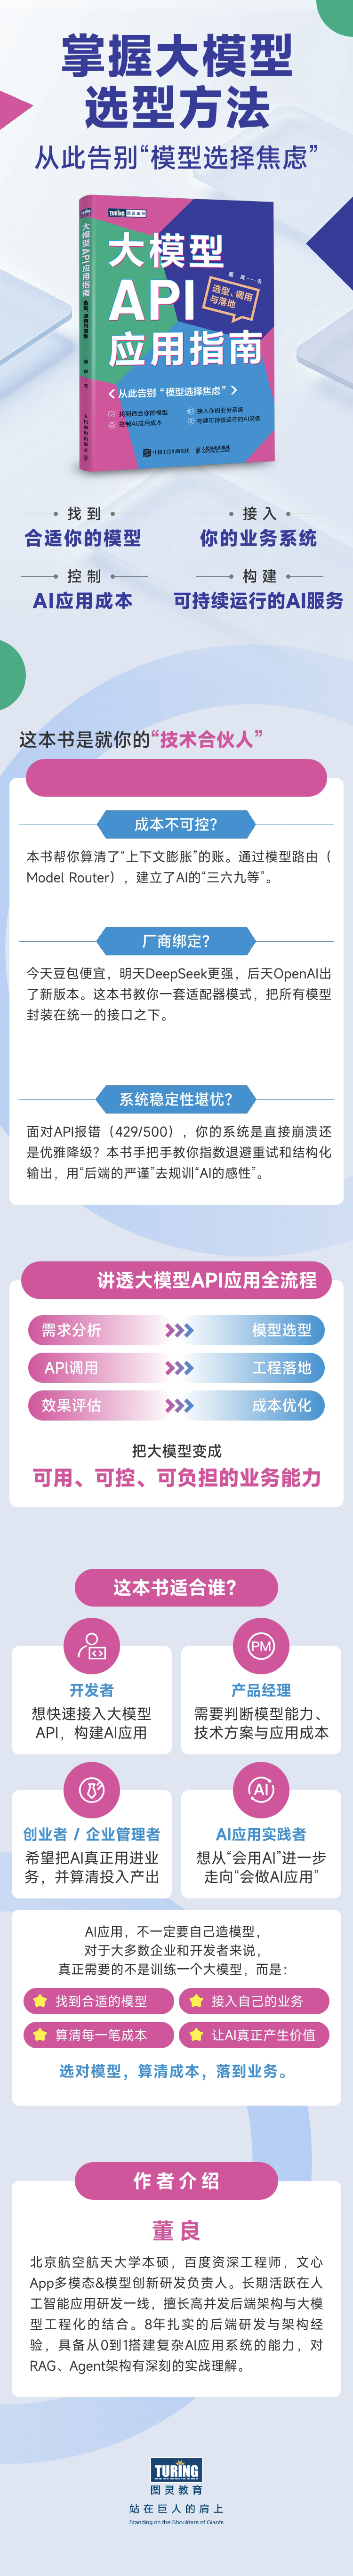
- 人民邮电出版社有限公司 (微信公众号认证)
- 人民邮电出版社微店,为您提供最全面,最专业的一站式购书服务
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...