商品详情

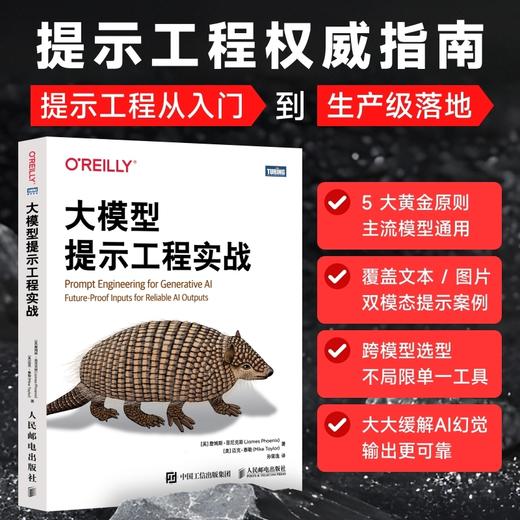
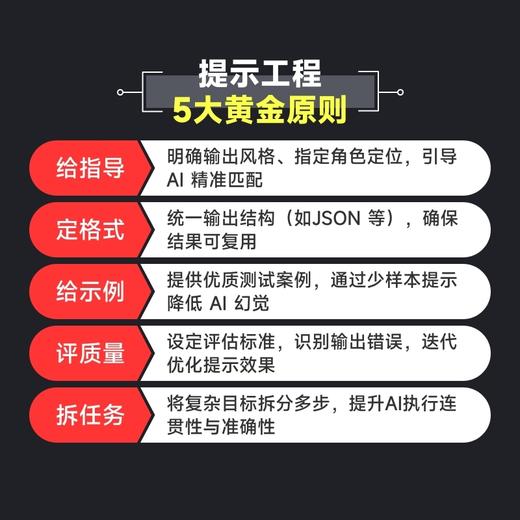
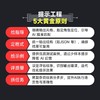
1_让 AI 不再;看运气帮你减少跑偏、胡编和格式混乱,让 AI 输出更稳定、更可用。2_不学提示词玄学不教;万能咒语,而是教你为什么这样提示有效,怎么长期有效。3_从聊天走向实用不只是和 AI 对话,而是让 AI 进入写作、编程、图像生成、自动化等真实工作场景。4_解决 AI 落地的核心痛点重点讲如何给方向、定格式、给示例、拆任务、评估结果,让 AI 产出更可靠。5_建立不过时的 AI 基本功模型会升级,工具会变化,但清楚表达任务、提供上下文、判断输出质量的能力不会过时。
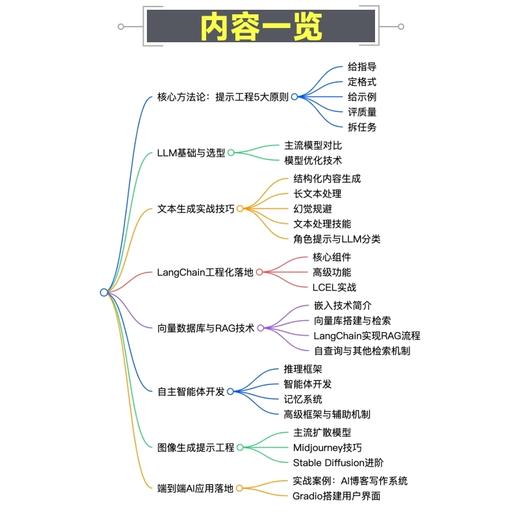
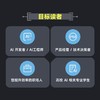
本书是广受欢迎的提示工程实战指南,兼顾系统性与实战性。本书囊括国际主流模型与开源工具,配套可直接复用的场景案例与实操方法。内容涉及提示工程的五大原则、主流 LLM/扩散模型实操、AI 应用开发、LangChain 落地技巧、RAG 方案及智能体开发等,形成了“原则_模型_实操_进阶”的清晰脉络,全面覆盖文本/图像生成、实际应用搭建等核心场景。本书适合 AI 应用开发者、机器学习工程师、技术创业者及需要落地提示工程的各类从业者阅读,也为内容创作、设计人员引入 AI 工具提效提供了参考。詹姆斯·菲尼克斯(James Phoenix)Vexpower联合创始人兼CTO。曾在全球知名科技与数字技能教育机构General Assembly担任数据科学讲师,累计授课时长超过600小时。迈克·泰勒(Mike Taylor)增长营销机构Ladder创始人,Vexpower联合创始人兼CEO。Ladder总部位于美国纽约,并在英国和欧盟设有办公室,曾为Meta、雀巢等知名品牌与企业提供服务。井 对本书的赞誉井 前言井 第 1章 提示工程的五大原则1.1 提示工程的五大原则概述1.2 原则一:提供指导1.3 原则二:指定格式1.4 原则三:提供示例1.5 原则四:评估质量1.6 原则五:任务拆分1.7 小结井 第 2章 面向文本生成的LLM2.1 什么是文本生成模型2.1.1 向量表示:语言的数值本质2.1.2 Transformer架构:组织上下文关系2.1.3 概率文本生成:决策机制2.2 历史背景:Transformer 架构的崛起2.3 OpenAI 的 GPT2.4 GPT_3.5 Turbo 与 ChatGPT2.5 GPT_42.6 Google Gemini2.7 Meta的Llama和开源2.8 通过量化和 LoRA 优化模型2.9 Mistral2.10 Anthropic的Claude2.11 GPT_4V2.12 模型比较2.13 小结井 第3章 使用 ChatGPT 进行文本生成的标准实践3.1 生成列表3.2 生成层级列表3.3 何时避免使用正则表达式3.4 生成 JSON3.5 YAML3.6 过滤 YAML 负载3.7 处理 YAML 中的无效负载3.8 ChatGPT生成多种格式的能力3.9 五岁小孩也能听懂3.10 通过 LLM 实现通用翻译3.11 请求上下文3.12 拆解文本风格3.12.1 识别所需文本特征3.12.2 使用提取出的特征生成新内容3.12.3 使用 LLM 提取特定文本特征3.13 摘要3.14 在上下文窗口受限时进行摘要3.15 文本分块3.15.1 文本分块的好处3.15.2 文本分块的应用场景3.15.3 不良分块示例3.16 分块策略3.17 使用 spaCy 进行句子检测3.18 在 Python 中构建一个简单的分块算法3.19 滑动窗口分块3.20 文本分块工具包3.21 使用 tiktoken 进行文本分块3.22 编码3.23 估算 Chat API 调用中的词元使用量3.24 情感分析3.24.1 提升情感分析效果的方法3.24.2 情感分析的局限和挑战3.25 从简到繁3.25.1 规划架构3.25.2 编写独立函数3.25.3 添加测试3.25.4 从简到繁的好处3.25.5 从简到繁的挑战3.26 角色提示3.26.1 角色提示的好处3.26.2 角色提示的挑战3.26.3 何时使用角色提示3.27 GPT提示词技巧3.27.1 使用参考文本避免幻觉3.27.2 给 GPT“思考时间”3.27.3 内心独白策略3.27.4 LLM自我评估响应3.28 使用 LLM 分类3.29 构建分类模型3.30 分类的多数投票法3.31 评估标准3.32 元提示3.33 小结井 第4章 LangChain 框架下的文本生成高级技巧4.1 LangChain简介4.2 聊天模型4.3 流式传输聊天模型4.4 生成多个响应4.5 LangChain提示词模板4.6 LangChain表达式语言(LCEL)4.7 在聊天模型中使用提示词模板4.8 输出解析器4.9 LangChain评估4.10 OpenAI 函数调用4.11 并行函数调用4.12 LangChain中的函数调用4.13 使用 LangChain 提取数据4.14 查询规划4.15 创建少样本提示词模板4.15.1 固定数量少样本示例4.15.2 格式化示例4.15.3 通过长度选择少样本示例4.16 少样本示例的局限性4.17 保存和加载 LLM 提示词4.18 数据连接4.19 文档加载器4.20 文本分割器4.21 按长度和词元数进行文本分割4.22 采用递归字符分割的文本分块方法4.23 任务分解4.24 提示词链4.25 itemgetter 和提取字典键4.26 LCEL 链4.26.1 文档链4.26.2 填充4.26.3 优化4.26.4 映射归约4.26.5 映射重排序4.27 小结井 第5章 利用 FAISS 和 Pinecone 构建向量数据库5.1 RAG5.2 嵌入技术简介5.3 文档加载5.4 使用 FAISS 进行记忆检索5.5 使用 LangChain 进行 RAG5.6 使用托管向量数据库 Pinecone5.7 自查询5.8 其他检索机制5.9 小结井 第6章 具备记忆和工具的自主智能体6.1 思维链6.2 智能体6.3 推理与行动(ReAct)框架6.3.1 ReAct的实现6.3.2 使用工具6.4 将 LLM 作为 API 使用(OpenAI 函数)6.5 比较 OpenAI 函数和 ReAct 框架6.5.1 OpenAI 函数的应用场景6.5.2 ReAct6.5.3 ReAct的使用案例6.6 智能体工具包6.7 定制标准智能体6.8 在 LCEL 中创建自定义智能体6.9 理解和使用记忆6.9.1 长期记忆6.9.2 短期记忆6.9.3 短期记忆在 QA 对话智能体中的应用6.10 LangChain中的记忆6.10.1 存储状态6.10.2 查询状态6.10.3 ConversationBufferMemory(对话缓冲记忆)6.11 LangChain中的其他常用记忆类型6.11.1 ConversationBufferWindowMemory(对话缓冲窗口记忆)6.11.2 ConversationSummaryMemory(对话摘要记忆)6.11.3 ConversationSummaryBufferMemory(对话摘要缓冲记忆)6.11.4 ConversationTokenBufferMemory(对话词元缓冲记忆)6.12 带记忆的 OpenAI 函数智能体6.13 高级智能体框架6.13.1 规划与执行智能体6.13.2 思维树6.14 回调6.14.1 全局(构造函数)回调6.14.2 请求级回调6.14.3 verbose 参数6.14.4 什么时候使用哪种方式6.15 使用 LangChain 计数词元6.16 小结井 第7章 图像生成扩散模型简介7.1 DALL·E7.2 Midjourney7.3 Stable Diffusion7.4 谷歌的图像生成模型7.5 文本生成视频7.6 模型比较7.7 小结井 第8章 Midjourney 图像生成标准实践8.1 格式修饰词8.2 艺术风格修饰词8.3 提示词逆向工程8.4 质量提升词8.5 负向提示词8.6 加权词8.7 使用图像作为提示词8.8 图像修补8.9 图像外扩8.10 角色一致性8.11 提示词重写8.12 模因拆解8.13 模因映射8.14 提示词分析8.15 小结井 第9章 使用 Stable Diffusion 进行图像生成的高级技巧9.1 运行 Stable Diffusion9.2 AUTOMATIC1111 web UI9.3 图生图9.4 放大图像9.5 CLIP反推9.6 SD图像修补和图像外扩9.7 ControlNet9.8 SAM(分割万物模型)9.9 DreamBooth微调9.10 SDXL精炼模型9.11 小结井 第 10章 构建 AI 驱动的应用10.1 AI博客写作10.2 主题调研10.3 专家访谈10.4 制定大纲10.5 生成文本10.6 写作风格10.7 优化标题10.8 AI博客图片10.9 用户界面10.10 小结- 新华一城书集 (微信公众号认证)
- 上海新华书店官方微信书店
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...