商品详情
前言我们身处大数据与互联网时代,数据无处不在。当今社会的;大数据通常有着比传统数据更高的量级、更快的收集速度和更丰富的类型。数据特征的这些时代性变化为我们带来了前所未有的机遇与挑战,对数据的存储、通信、分析、计算、优化以及隐私等诸多方面均提出了更高的要求。为了应对这些挑战,;数据科学应运而生,它综合了统计、数学、计算机科学和信息科学等各学科领域的理论和方法,将数据变得;智能,旨在从数据中挖掘、提取有效的信息,从而帮助人们制定决策或者获取新的知识。事实上,;数据科学的概念已存在数十年,但不同领域的研究人员对于这一学科的理解不尽相同。而近年来随着交叉学科研究的深入发展,各个数据相关的学科早已相互渗透。因此,数据科学也逐渐成为一门跨领域的学科,可以处理不同场景、不同维度(低维或高维)及不同类型(结构化、非结构化、半结构化)的数据,有针对性地开发新的方法、理论、算法及系统,从而使数据产生科学价值或商业价值。在分析这些庞杂的数据时,统计建模的方法论可以帮助人们量化并把握科学假设及分析结果的不确定性,在数据的价值实现过程中扮演着重要的角色。鉴于此,我们将在本书中为读者介绍数据科学中常用的统计模型、当代统计机器学习的技术和算法,以及它们背后充分、完备的数学逻辑和统计理论。然而,近年来数据科学这一新兴领域的发展如火如荼,所涉及的研究问题非常广泛,并且出版刊物数量激增,如何更合理地选择书中涵盖的主题、更好地平衡数据科学中的统计理论和应用是我们面临的一大挑战。经过思考和讨论,我们将本书的重点放在应用较为广泛的高维数据分析方法方面。当今前沿的科学研究通常依赖信息维度很高的海量数据,这些高维数据在自然科学、工程学、人文社科等领域随处可见,但信息维度的大幅上升使得很多传统的统计分析方法不再适用,因此针对高维数据的分析方法在数据科学的研究中至关重要。本书的作者从事高维统计的相关科研工作均已超过二十年,多年前就着手撰写高维数据分析的书籍。在本书中,我们将高维统计方法融入数据科学,为读者提供稀疏性学习、协方差研究、机器学习和统计推断等领域的系统介绍。具体而言,本书的内容主要分为以下四个部分:VI. 在高维数据分析中,稀疏性是一个非常常见的假设。所谓稀疏性是指在一个巨大的资源池中,我们只需使用少量特性便可以解决某些科学问题或做出预测。本书介绍了处理稀疏性的各种正则化方法,包括如何确定惩罚函数、如何选取正则化方法中的参数、针对不同统计模型如何进行数值优化等。这些主题详见第3~6 章及第 8 章。. 高维变量通常是相互关联的,特别是当用这些变量测量类似的事物(如经济指标或个人健康指标)时。为了研究变量之间的相依关系,我们可采用因子模型来刻画数据矩阵的低秩性和稀疏结构,该模型可通过高维协方差的稳健主成分分析来求解。这种因子模型或更具一般性的潜在结构学习也可以被视为无监督统计机器学习。另外,海量的数据有时会导致数据分布的重尾性这就需要稳健的统计方法来消除异常值的影响,因此稳健的协方差学习、主成分分析以及它们在社区发现、主题模型、推荐系统等方面的应用也是本书的一大特色。这些主题详见第 9~11 章。. 机器学习也是分析高维复杂数据的关键,所以本书还为读者提供了较为全面的机器学习方法和算法介绍,分为有监督的机器学习方法及无监督的机器学习方法。有监督学习指响应变量(通常是分类变量)可观测的情形,学习目标是根据输入变量预测响应变量的标签。相对地,无监督学习中,响应变量不存在或不可观测,学习目标通常为研究变量间的关联模式。这些问题研究有时还涉及特征的构造和稀疏性学习。详见第 2 章和第 12~14 章。. 统计推断也是本书的主要关注点。统计推断需要描述统计量的不确定性,推导估计量的标准误差及构造检验统计量的渐近分布,而这些问题在高维数据设定下变得非常棘手。具体的挑战及解决方法详见第 7 章。本书可用作数据科学、统计学等相关专业的研究生教材,也是关于稀疏性、协方差方法论、机器学习和统计推断等领域的研究专著。例如,一个学期的研究生课程可涵盖本书第 2、3、9、10、12、13 章的内容,以及从剩余章节中挑选的一些内容,这些内容对统计机器学习的模型、理论和方法进行了全面的介绍。另一种研究生课程设计涵盖第2、3、5、7、8 章的内容以及从剩余章节中挑选的内容,这一设计更侧重于高维统计、模型选择和推断。另外需要说明的是,在大数据分析和处理需求激增的推动下,在统计学、计算机科学、信息科学、应用和计算数学等各个领域的数据科学家的贡献下,过去十几年高维统计和机器学习取得了快速且巨大的进步。尽管我们已经将本书的范围缩小到数据科学的统计方法论方面,但此方面所涉及的研究问题仍然非常广泛,许多该领域的重要工作由VII于与本书的主要关注方向差异较大而未被涵盖,我们对此表示歉意。在本书的内容贡献方面,Jianqing Fan 主要负责第 1、3 章、第 9~11 章、第 14 章和其他章节的部分内容,Runze Li 主要负责第 5 章、第 8 章和第 6~7 章的部分内容,Cun_Hui Zhang 主要负责第 4 章和第 7 章,Hui Zou 主要负责第 2、6、11、12 章和第5 章的部分内容。同时,所有作者对本书的全部内容负责。还有许多人也为本书的完成做出了重要贡献。我们要特别感谢主编 John Kimmel 十多年来给予我们的帮助和耐心。我们非常感谢大约 10 位匿名审阅者的宝贵意见,帮助我们打磨本书。我们特别感谢 Cong Ma 和 Yiqiao Zhong 为第 14 章撰写草稿,Zhao Chen帮助我们整合素材、统一格式,Tracy Ke、Bryan Kelly、Dacheng Xiu 和 Jia Wang 帮助我们构建图 1.3,Krishna Balasubramanian、Cong Ma、Lingzhou Xue、Boxiang Wang、Kaizheng Wang、Yi Yang 和 Ziwei Zhu 帮助我们制作部分图表。很多朋友帮助我们仔细校对了本书的某些章节,并提出了有用的建议。他们是 Krishna Balasubramanian、Pierre Bayle、Alexander Chen、Elynn Chen、Wenyan Gong、Yongyi Guo、Bai Jiang、Cong Ma、Igor Silin、Qiang Sun、Francesca Tang、Bingyan Wang、Kaizheng Wang、Weichen Wang、Yuling Yan、Zhuoran Yang、Mengxin Yu、Wen_Xin Zhou、Yifeng Zhou和 Ziwei Zhu。我们在这里对他们表示衷心的感谢。我们在 2019 年和 2020 年普林斯顿大学一年级研究生课程和 2019 年宾夕法尼亚州立大学高年级研究生专题课程中使用了本书的初稿作为教材。我们要感谢当时班级中研究生的认真阅读。尤其要感谢 Cong Ma、Kaizheng Wang 和 Zongjun Tan,他们协助我们准备了普林斯顿大学的课程作业题,其中大部分已被纳入本书各章末的习题。在普林斯顿大学,我们讲过的内容包含本书中的第 2 章、第 3 章、第 5 章、8.1 节、8.3 节、第 9~12 章、13.1~13.3 节,以及第 14 章。最后,我们想在这里感谢我们的老师,感谢所有与我们进行过许多愉快合作的同事和伙伴,感谢来自家人的爱、陪伴和支持。Jianqing FanRunze LiCun_Hui ZhangHui Zou本书网站:
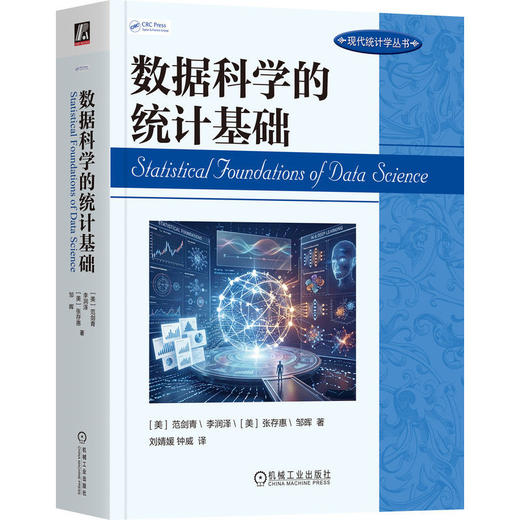
本书为著名统计学家范剑青、李润泽、张存惠和邹晖的联手之作。书中系统、全面地讲述了数据科学的统计基础的理论和方法论。本书可作为一本工具书,供从事数据分析、人工智能研究的专业人员查阅,也可作为一本文献索引,为统计学、数据科学、机器学习相关专业的高年级本科生和研究生梳理数据科学的统计基础的发展历程。
本书是由四位著名统计学家花费十余年联合撰写的一本阐释数据科学的统计建模方法论的著作。为了很好地平衡理论与应用,本书在内容上做了取舍,将重点放在当下应用较为广泛的高维数据分析方法上。书中从大数据的起源及其对统计分析的影响入手,系统介绍了数据科学领域常用统计模型、现代统计机器学习方法与算法,阐释其数学原理和统计理论。书中内容层层递进,兼顾理论证明、算法实现与实际应用,全面覆盖多元回归、惩罚最小二乘、广义线性模型、M 估计等高维建模方法,深入分析估计性质与统计推断,涵盖特征筛选、协方差矩阵、图模型、因子模型等核心内容,并延伸至有监督学习、无监督学习及深度学习。本书既可作为统计学、数据科学、机器学习相关专业的高年级本科生和研究生的教材,也可供从事数据分析、人工智能研究的专业人员学习使用。
??作者是国际权威人士,也是本书的领导者。他们都是数理统计学会和美国统计协会的研究员。 Jianqing Fan是普林斯顿大学弗雷德里克摩尔教授。他是《商业与经济统计杂志》的合编人,曾是《统计年鉴》、《概率论及相关领域》和《计量经济学杂志》的联合主编,并获得了2000年COPSS总统奖、AAAS研究员、古根海姆研究员、盖伊银质奖章、Noether高级学者奖,中央研究院院士。 Runze Li是宾夕法尼亚州立大学埃尔伯里家庭讲座教授和AAAS研究员,也是《统计年鉴》的联合编辑。 Cun_Hui Zhang是罗格斯大学特聘教授,《统计科学》合编。 Hui Zou是明尼苏达大学教授,曾任《机器学习研究杂志》的行动编辑。
译者序前言第 1 章 绪论 11.1 大数据的起源与维度的概念 11.2 大数据的影响 81.3 维度的影响 101.4 高维统计学习的目标 161.5 大数据能够做什么 171.6 本书的范围 17第 2 章 多元回归和非参数回归 182.1 本章内容概览 182.2 多元线性回归 182.3 加权最小二乘法 242.4 Box_Cox 变换 262.5 建模的方法和基展开 282.6 岭回归 342.7 再生核希尔伯特空间中的回归问题 402.8 留一法交叉验证和广义交叉验证 452.9 习题 48第 3 章 惩罚最小二乘法 523.1 经典变量选择准则 523.2 折叠凹惩罚最小二乘法 563.3 Lasso 和 .1 正则化 633.4 贝叶斯变量选择 793.5 数值算法 813.6 惩罚最小二乘的正则化参数 973.7 残差方差和重拟合交叉验证 1013.8 惩罚最小二乘在非参数模型中的扩展 1043.9 应用 1073.10 本章文献注释 1113.11 习题 113第 4 章 惩罚最小二乘估计的性质 1174.1 理论基础 1174.2 基于 .0 惩罚的变量选择 1364.3 Lasso 和 Dantzig 选择器 1424.4 凹惩罚最小二乘的性质 1824.5 轻度惩罚和排序惩罚 2064.6 本章文献注释 2254.7 习题 226第 5 章 广义线性模型和惩罚似然方法 2275.1 广义线性模型 2275.2 常用的广义线性模型 2385.3 高置信集中最稀疏的系数IX估计 2445.4 基于惩罚似然的变量选择 2465.5 算法 2495.6 调节参数的选取 2525.7 实证分析示例 2545.8 低维情形下参数估计的抽样性质 2565.9 超高维度下的理论性质 2645.10 惩罚似然估计的风险性质 2745.11 本章文献注释 2785.12 习题 2795.13 本章附录 283第 6 章 惩罚 M 估计 2846.1 惩罚分位数回归 2846.2 惩罚复合分位数回归 2916.3 稳健回归中的变量选择 2946.4 秩回归与秩回归中的变量选择 2996.5 生存分析中的变量选择 3016.6 折叠凹惩罚 M 估计的理论性质 3056.7 本章文献注释 3156.8 习题 316第 7 章 高维统计推断 3177.1 线性回归的统计推断 3187.2 高维广义线性模型的统计推断 3267.3 渐近有效性理论 3357.4 高斯图模型 3517.5 解的一般形式 3647.6 本章文献注释 3737.7 习题 374第 8 章 特征筛选 3778.1 基于相关性的筛选 3778.2 广义相关性筛选与秩相关性筛选 3818.3 参数模型的特征筛选方法 3838.4 非参数模型的特征筛选方法 3898.5 不依赖模型的特征筛选方法 3958.6 特征筛选和变量选择 4028.7 重拟合交叉验证 4098.8 实证分析案例 4158.9 本章文献注释 4188.10 习题 419第 9 章 协方差矩阵的正则化和图模型 4219.1 矩阵基础 4219.2 稀疏协方差矩阵估计 4259.3 稳健协方差矩阵估计 4339.4 稀疏精度矩阵和图模型 4369.5 潜在高斯图模型 4479.6 技术证明部分 4509.7 本章文献注释 4559.8 习题 456第 10 章 协方差学习与因子模型 45910.1 主成分分析 45910.2 因子模型和结构化协方差学习 46210.3 因子已知时的协方差矩阵和精度矩阵的估计 471X10.4 增广因子模型与投影 PCA 47610.5 渐近性质 47910.6 证明 48310.7 本章文献注释 49410.8 习题 495第 11 章 因子模型及主成分分析的应用 49911.1 基于因子调整的正则化模型选择 49911.2 基于因子调整的稳健多重检验 50511.3 因子增广回归方法 51411.4 主成分分析在统计机器学习中的应用 51811.5 本章文献注释 53411.6 习题 535第 12 章 有监督学习 53712.1 基于模型的分类器 53712.2 核密度分类器和朴素贝叶斯 54212.3 最近邻分类器 54712.4 分类树和集成分类器 54812.5 支持向量机 55812.6 基于惩罚经验损失的稀疏分类器 56312.7 稀疏判别分析 56812.8 特征增广与稀疏可加分类器 57812.9 本章文献注释 58312.10 习题 584第 13 章 无监督学习 58813.1 聚类分析 58813.2 类别个数的数据驱动选择法 59813.3 聚类分析中的变量选择 60113.4 高维主成分分析 60813.5 稀疏主成分分析 61113.6 本章文献注释 62013.7 习题 621第 14 章 深度学习 62314.1 深度学习的兴起 62314.2 前馈神经网络 62514.3 流行的模型 62914.4 深度无监督学习 63814.5 训练深度神经网络 64314.6 案例:图像分类 64914.7 基于 TensorFlow 和 R 的额外案例 65114.8 本章文献注释 662参考文献 664
本书全面总结了数据科学的统计基础的发展历程。本书的几位作者活跃在前沿研究领域,并对该学科做出了多项关键贡献。因此,本书极好地呈现了该领域的最新进展。它既适合统计学专业的研究生阅读,也适用于应用和理论数据科学领域的研究人员。本书以通俗易懂的方式简要汇总了大量重要研究论文,因此可作为主题索引。书中对各主题的核心概念做了出色梳理,方便有经验的研究人员通过独立阅读具体章节和段落把握整体脉络,无须逐一研读大量技术性文献。全书共14章,可作为两学期的教材使用。本书还提供了实用代码与数据集,对从业者而言是一笔宝贵财富。Journal of Time Series Analysis
这本由著名统计学家范剑青(普林斯顿大学)、李润泽(宾夕法尼亚州立大学)、张存惠(罗格斯大学)和邹晖(明尼苏达大学)合著的教材,精心编纂并阐释了数据科学与大数据分析领域的理论与方法论成果。在当下充斥着以代码为核心的数据科学;食谱类书籍的环境中,本书是一部聚焦于正则化回归、高维数据分析与机器学习背后的数学和统计学原理及方法的难得著作。本书的巅峰成就在于,它对统计回归中的稀疏性与模型选择进行了全面探索,涵盖了广义线性回归、惩罚最小二乘法、分位数与稳健回归以及生存回归等模型。作者不仅从各类惩罚项的角度探讨了稀疏性,还将其视为数值优化算法的重要特征这类算法如今已广泛应用于深度学习等诸多领域。书中深入探究了当代高维数据建模方法,如特征筛选、协变量正则化、图模型以及主成分分析与因子分析。作者们在本书末尾将内容延伸至当代统计机器学习,涵盖监督与无监督学习技术及深度学习等一系列主题。对于渴望深入研习数据科学理论严谨性的读者而言,本书是不容错过的经典之选。Choice Reviews,S_T. Kim(北卡罗来纳农工州立大学),2021年8月
- 新华一城书集 (微信公众号认证)
- 上海新华书店官方微信书店
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...