商品详情
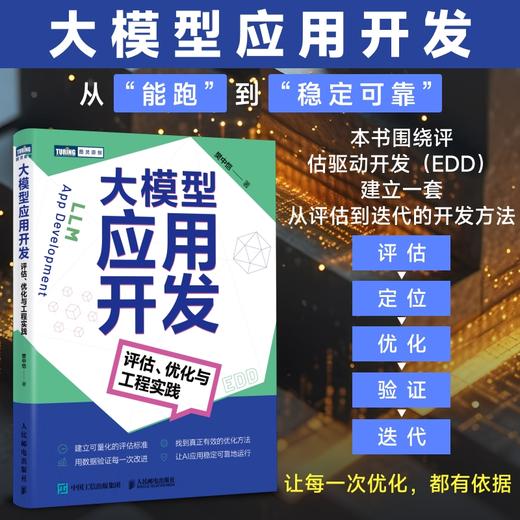
书名:大模型应用开发:评估、优化与工程实践
定价:109.8
ISBN:9787115705747
作者:樊中恺
版次:第1版
出版时间:2026-09
内容提要:
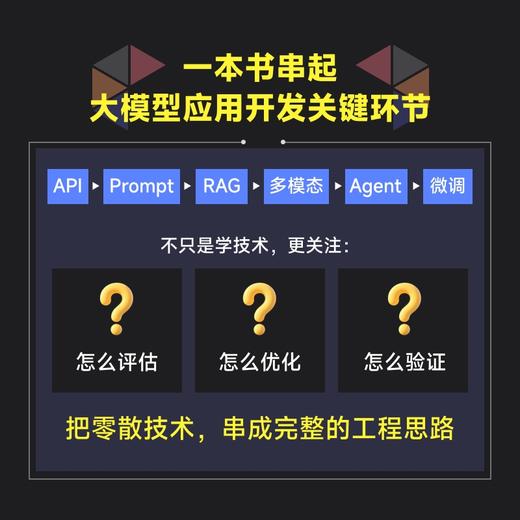
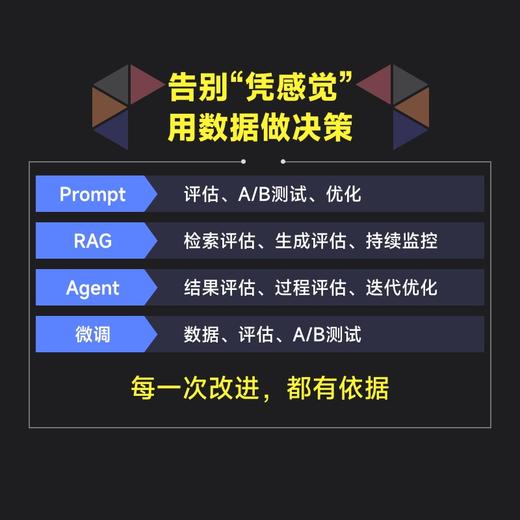
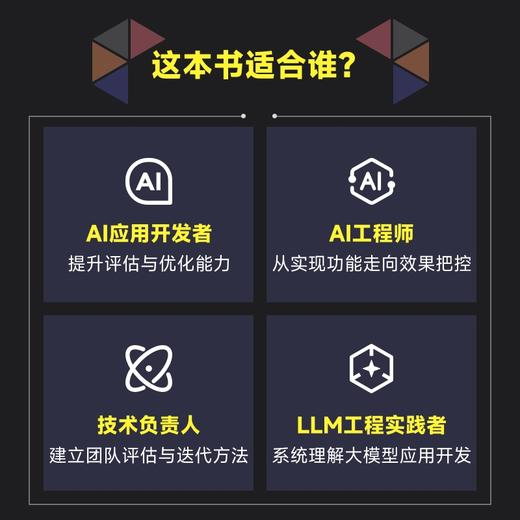
本书系统阐述企业级AI原生应用开发的核心方法论——评估驱动开发(EDD)。面对大语言模型带来的不确定性,传统软件开发模式已难以为继。本书从模型API选型与评估、Prompt工程优化、RAG系统构建、多轮对话系统、多模态应用、Agentic AI智能体到模型微调,贯穿AI应用开发全流程,以“评估-优化-验证”循环为技术决策基准。通过丰富的代码示例和实战案例,帮助读者建立可量化、可迭代的质量保障体系,成为既懂技术又懂效果把控的AI工程师。适合AI应用*、技术负责人及对LLM工程化感兴趣的读者。
作者简介:
樊中恺,百度主任架构师,涉及搜索、信息流和 AI Native 应用。23 年开始负责文心 APP 产品策略研发工作,指导团队开发多智能体群聊、放心写作、魔法漫画等创新产品,在 Agentic AI、业务模型调优、AI Native 应用架构等方向有深厚的技术积累和丰富的业务经验。是 QCon、CSDI、Create AI、百度世界等行业峰会的出品人、*讲师和公开课负责人。出版并翻译《Web 智能化》、《程序员数学》、《高性能 MVVM 框架的设计与实现》、《微前端设计与实现》等书籍,参与央视等媒体的 AI 主题专访,在社区和公司内外贡献 Prompt Engineer、AI Native 应用架构设计等主题的在线课程。
目录:
0 前言
1 第 一章 评估驱动开发(EDD)概念
1.1 从确定性到概率性的范式转换
1.1.1 两个世界的根本差异
1.1.2 AI Engineer的角色演进
1.1.3 EDD的核心理念与实践框架
1.2 EDD的实施策略与应用场景
1.2.1 模型效果评估
1.2.2 上下文工程评估
1.2.3 Agentic AI的端到端评估
1.3 EDD评估体系的设计与实施
1.3.1 评估目标的科学设定
1.3.2 评估方法的选择与设计
1.3.3 持续优化的反馈机制
2 *章 模型API使用和效果评估
2.1 快速开始第 一个API调用
2.1.1 平台选择与注册策略
2.1.2 环境配置与依赖管理
2.1.3 第 一个API调用:从Hello World到生产级代码
2.1.4 统一的评估基准建立
2.2 参数调优与实验设计
2.2.1 Temperature
2.2.2 Top-P
2.2.3 Max Tokens
2.2.4 其他关键参数
2.2.5 参数协同效应与工程化调优实践
2.3 API使用基础与*实践
2.3.1 API Key管理与*实践
2.3.2 同步输出与流式输出
2.4 *调用技巧
2.4.1 异步并发调用架构设计
2.4.2 请求生命周期管理
2.4.3 智能重试与降级策略
2.5 性能监控与自适应优化
2.5.1 多维度监控体系
2.5.2 智能决策引擎
2.5.3 预测性优化
2.5.4 实战中的闭环优化
2.6 模型评估与迭代管理
2.6.1 模型迭代的本质与挑战
2.6.2 ROI驱动的迁移决策
3 第三章 Prompt工程与评估优化
3.1 Prompt工程的真实挑战
3.1.1 从碰运气到工程化的转变
3.1.2 Prompt工程的三大技术挑战
3.1.3 评估驱动的解决方案
3.2 Prompt模板设计的实战技巧
3.2.1 *越技巧:理解Prompt设计的第 一性原理
3.2.2 模板的版本管理与A/B测试
3.2.3 领域模板库的构建
3.3 评估驱动的优化闭环
3.3.1 *小可行评估体系(MVE)
3.3.2 问题定位的方法
3.3.3 渐进式优化策略
3.3.4 优化收益的量化
3.4 Prompt进阶技术
3.4.1 用CoT对抗注意力漂移
3.4.2 用弹性边界破解创意控制悖论
3.4.3 用结构化提示解决上下文污染
3.4.4 举例:智能客服
4 第四章 多轮对话系统的构建与评估
4.1 多轮对话系统架构设计
4.1.1 对话系统的核心概念
4.1.2 对话“树”
4.1.3 系统架构设计模式
4.1.4 对话状态的表示与存储
4.2 多轮对话的特殊挑战
4.2.1 连贯性维持的技术挑战
4.2.2 记忆信息的选择性保持
4.2.3 用户意图的动态变化处理
4.2.4 对话完整度的保证
4.3 多轮对话评估方法论
4.3.1 传统单轮评估方法的局限性
4.3.2 多轮评估的核心维度
4.3.3 自动化评估指标设计
4.3.4 人工评估标准化流程
4.4 MT-Bench式评估系统实现
4.4.1 MT-Bench评估框架解析
4.4.2 评估数据集的构建
4.4.3 LLM-as-judge评判系统落地
4.4.4 评估结果的分析与可视化
4.4.5 系统实现与部署
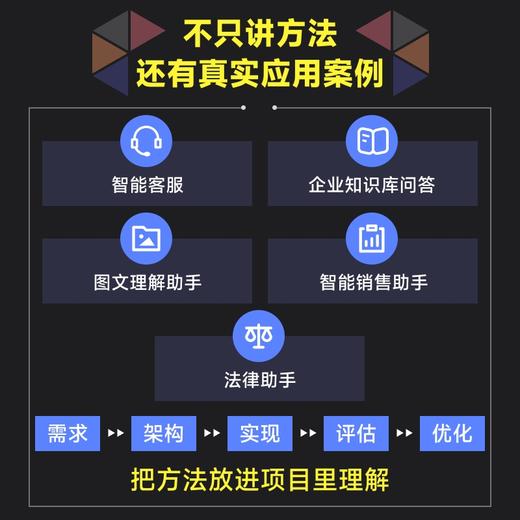
4.5 实战案例:智能客服多轮对话系统
4.5.1 系统需求与架构设计
4.5.2 核心模块实现
4.5.3 评估体系构建
4.5.4 优化策略与*实践
5 第五章 RAG系统的构建与评估优化
5.1 RAG系统的本质与架构演进
5.1.1 从知识的角度理解RAG
5.1.2 RAG架构的演进历程
5.1.3 RAG的核心组件剖析
5.1.4 RAG与其他技术的融合
5.2 文档工程:RAG系统的数据基础
5.2.1 文档处理
5.2.2 元数据
5.2.3 多模态文档的处理
5.3 检索策略的设计与优化
5.3.1 从单一检索到混合检索的演进
5.3.2 查询理解与改写
5.3.3 检索结果的重排序与过滤
5.3.4 多跳检索与推理
5.4 RAG评估体系的建立
5.4.1 评估的多维度视角
5.4.2 检索质量的评估方法
5.4.3 生成质量的评估
5.4.4 在线评估与持续监控
5.5 RAG系统的优化策略
5.5.1 索引优化:效率与效果的平衡
5.5.2 提示工程优化
5.5.3 缓存策略
5.5.4 动态模型选择
5.6 RAG系统的实战案例
5.6.1 企业知识库问答系统
5.6.2 性能优化案例
5.7 未来展望与发展趋势
6 第六章 多模态系统的构建与评估
6.1 多模态AI的本质与架构演进
6.1.1 从单模态到多模态的认知跨越
6.1.2 多模态架构的演进路径
6.1.3 多模态系统的核心组件
6.2 多模态模型的评估挑战与方法
6.2.1 评估的特殊性
6.2.2 自动化评估指标体系
6.2.3 基于模型的评估
6.2.4 人类评估的*实践
6.3 多模态RAG:融合检索的新范式
6.3.1 为什么需要多模态RAG
6.3.2 多模态RAG的架构设计
6.3.3 多模态RAG的特殊挑战
6.4 实践案例:图文理解助手
6.4.1 系统需求与架构
6.4.2 核心模块实现
6.4.3 评估体系设计
7 第七章 Agentic AI智能体系统的构建与评估
7.1 从LLM到Agent的差异
7.1.1 传统LLM的局限
7.1.2 Agent的定义与核心特征
7.1.3 Agent的认知闭环
7.1.4 典型场景对比:LLM与Agent的差异可视化
7.2 架构演进
7.2.1 架构设计的核心原则
7.2.2 四代架构演进
7.2.3 架构选择的核心依据
7.3 Agent实现
7.3.1 工具与记忆系统的通用设计
7.3.2 ReAct架构
7.3.3 Planner-Executor架构
7.4 多Agent协同
7.4.1 多Agent协同的价值
7.4.2 多Agent协同的核心挑战与解决方案
7.4.3 多Agent协同的核心实现
7.5 评估与优化:构建Agent系统的“健康指标”与迭代策略
7.5.1 多维度评估体系:从“结果对不对”到“过程优不优”
7.5.2 基于评估的优化策略:问题驱动的*迭代
7.6 实践案例:企业级智能销售助手的设计与落地
7.6.1 需求分析
7.6.2 架构设计
7.6.3 核心实现
7.6.4 落地效果与持续优化
7.7 未来趋势与挑战
7.7.1 四大核心趋势
7.7.2 三大核心挑战
8 第八章 模型微调与定制化
8.1 关于微调
8.1.1 微调的本质
8.1.2 微调、Prompt、RAG
8.1.3 微调技术演进
8.1.4 合成数据
8.2 数据工程
8.2.1 核心原则
8.2.2 数据清洗
8.2.3 数据配比
8.3 参数*微调(PEFT)
8.3.1 LoRA家族
8.3.2 动态决策框架
8.3.3 多LoRA管理:动态切换与组合的技术实现
8.4 对齐技术
8.4.1 DPO
8.4.2 *性对齐
8.5 微调评估:多维度框架与在线实践
8.5.1 LLM-as-Judge:当前微调评估的核心工具
8.5.2 在线A/B测试:生产环境的*终验证
8.6 实战案例:法律助手
8.6.1 需求与数据准备
8.6.2 微调实施
8.6.3 评估与迭代
9 第九章 简单实用的EDD
9.1 评估轻量化
9.1.1 自动化评估
9.1.2 小模型适配
9.2 应用拓展
9.2.1 实时交互场景
9.2.2 行业微场景
9.3 落地挑战:中小团队的“低成本突破路径”
9.3.1 成本控制
9.3.2 门槛降低
9.3.3 迭代加速
9.4 落地路径:中小团队的“极简三步法” 
- 人民邮电出版社有限公司 (微信公众号认证)
- 人民邮电出版社微店,为您提供最全面,最专业的一站式购书服务
- 扫描二维码,访问我们的微信店铺
- 随时随地的购物、客服咨询、查询订单和物流...